架构视界
主页
企业架构
  • 方案总览
  • 业财一体
  • 企业中台
  • 组织与绩效
  • 流程治理
数据收集与分析
  • 转型总览
  • 信息化阶段
  • 数字化解决方案
  • 智数化解决方案
  • 智能化解决方案
  • 产品设计
  • 项目管理
全栈软件工程
AI 原生软件工程
方法论
博客
  • 资源导航
  • 效率工具
  • 展示专区
主页
企业架构
  • 方案总览
  • 业财一体
  • 企业中台
  • 组织与绩效
  • 流程治理
数据收集与分析
  • 转型总览
  • 信息化阶段
  • 数字化解决方案
  • 智数化解决方案
  • 智能化解决方案
  • 产品设计
  • 项目管理
全栈软件工程
AI 原生软件工程
方法论
博客
  • 资源导航
  • 效率工具
  • 展示专区
  • 标签索引
  • 2024年

    • 勇闯大A:美债与美元周期
    • 勇闯大A:交易纪律与自我管理
    • 勇闯大A:交易系统分层
    • 勇闯大A:买卖点与止损规则
    • 勇闯大A:债券与资金流向
    • 勇闯大A:微观、宏观与周期
    • Mac 开发环境:新机配置清单
    • 勇闯大A:内外盘与换手率
    • 会计管理:财报阅读与管理报表
    • 会计基础:记账原理与分录
    • 财务入门:财务体系全景
  • 2023年

    • 境外投资:泰国 BOI 申请实务
  • 2022年

    • 企业架构:故障管理与分级响应
    • 企业架构:技术债务的识别、度量与偿还
  • 2021年

    • Python 数据分析:员工分布可视化
    • Python 数据分析:IP 访问折线图
    • Python 数据分析:IP 词云图
    • Redis:RediSearch 全文检索
    • Rust 基础:第一个 CLI 程序
    • Rust 基础:所有权机制
    • Rust 基础:函数与控制流
    • Rust 基础:变量与数据类型
    • Rust 基础:入门与开发环境
    • 企业架构:分布式系统设计
    • 企业架构:编程式权限设计
    • JVM 调优:启动参数与 GC 日志
    • MyBatis 批量插入:三种写法对比
    • 测试:Spring Boot 分层 Mock
    • Redis:布隆过滤器判断元素存在
    • Jenkins:安装配置与应用部署
    • WebClient:非阻塞 HTTP 客户端
    • Drone:Docker 部署轻量 CI
    • Spring AOP:操作审计日志落库
    • Redisson:分布式锁与 RedLock
    • MyBatis 拦截器:雪花算法主键
    • Netty:线程模型与网络编程
    • Redis:SCAN 游标遍历大键空间
    • Jenkins:单机部署与升级脚本
    • Mac:Neo4j 与 Jupyter 安装
    • JavaFX:OpenJDK 11 环境配置
    • Mac:用 jenv 管理 JDK 版本
    • Redis:有序集合实现延时队列
    • Spring Boot 日志:MDC 串联链路
    • 定时任务:Spring 调度与 Cron
    • GoAccess:Nginx 日志分析
    • MyBatis 拦截器:慢 SQL 分析
    • Lucene:倒排索引与中文分词
    • 分布式锁:三种实现方案对比
    • 学习技巧:减少学习排斥心理
    • 动态数据源:多租户数据路由
    • Compose:Spring Boot 三件套
    • Java 阻塞队列:源码与用法
    • Redis:Docker Compose 哨兵
    • Redis:Docker Compose 主从
    • 网络通信:TCP/IP 与 HTTP 基础
  • 2020年

    • 延时队列:DelayQueue 与 Redis 实现
    • MySQL 基础:员工库导入实践
    • 雪花算法:分布式 ID 生成
    • Redis:地理位置查询
    • 抓包:Wireshark 与 Tcpdump
    • SPI:JDK 与 Spring 扩展机制
    • ZooKeeper:概念与集群搭建
    • Spring Boot:集成 JMH 基准测试
    • Wireshark:抓包工具入门
    • Compose:Redis 与 MySQL
    • CentOS 7:Docker 安装部署
    • Netty:源码阅读环境搭建
    • MySQL 基础:SQL 常见用法
    • CentOS 7:Selenium 运行环境
    • Nginx:HTTPS 证书配置
    • JMH:基准测试与 Spring Boot 集成
    • Spring Boot:指定 Tomcat 版本
    • Eureka:实例上下线告警
    • 钉钉告警:应用异常与实例上下线
    • JVM:内存布局、类加载与调优
    • Git:rebase 合并多次提交
    • CentOS 7:OpenResty 部署
  • 2019年

    • Redis CLI:macOS 安装与使用
    • Nginx:访问日志格式
    • 工程规范:可维护代码的写法
    • IntelliJ IDEA:常用插件
    • SkyWalking:源码阅读环境搭建
    • Spring Boot:Redis 超时配置
    • gRPC:ProtoBuf 定义与代码生成
    • Arthas:Java 线上问题诊断
    • Redis:缓存穿透与击穿防护
    • Docker 部署:Elasticsearch
    • Docker 部署:MySQL 5.7 单机
    • Spring Redis:字符串命令封装
    • Docker 部署:ZooKeeper 运行
    • Docker 部署:Redis 单机运行
    • Dubbo:Spring Boot 微服务集成
    • CentOS 7:CMake 源码编译安装
    • 性能度量:吞吐量与 QPS 指标
    • Java 递归:从笔试题到经典问题
    • CentOS 7:ELK 日志平台部署
    • CentOS 7:SonarQube 部署
    • Selenium:Chrome 浏览器自动化
    • JJWT:令牌生成与解析测试
    • Spring 源码:阅读环境搭建
    • JUnit 4:注解、断言与参数化
    • JWT:令牌结构与签名机制
    • FastDFS:架构与文件存取机制
    • XPath:XML 文档节点定位
    • Redis 基础:锁、队列与事务
    • Redis 基础:数据类型与命令
    • MyBatis:Slf4j 日志接入
    • MyBatis:H2 单元测试与 SQL 日志
    • 源码阅读:开源项目环境搭建
    • Git 配置:命令清单与作用域
    • Java 核心:面向对象与基础类型
    • Java 核心:关键字、异常与反射
    • Java 核心:多线程基础
    • Java 核心:同步关键字与线程池
    • Java 核心:锁与并发工具
    • Java 核心:语言基础与并发
    • Dubbo:远程调用与服务治理
    • Java 集合:框架总览与实现对比
    • Maven:生命周期与常用命令
    • MyBatis:执行流程与插件机制
    • Spring:IoC 容器与依赖注入
    • Spring:AOP 与自动装配
    • Spring:事务与启动流程
    • Spring:IoC、AOP 与事务
    • Spring MVC:请求分发与注解
    • MySQL:架构与索引
    • MySQL:事务、锁与 MVCC
    • MySQL:日志与 SQL 优化
    • MySQL:架构、事务与优化
    • Redis 基础:持久化与线程模型
  • 2018年

    • Java HashMap:扩容机制与哈希冲突
    • Java 集合:HashSet 去重原理
    • Java 基础:交换两个变量的值
    • Spring MVC:零 web.xml 改造
    • Mac 开发环境:新机配置清单
    • Log4j:日志分级与按业务拆分
    • Modbus:工业通信协议与 RTU 帧
    • MySQL 基础:子查询与连接查询
    • MySQL 基础:库与表操作
    • MySQL 基础:表操作与查询
    • MySQL 基础:约束、引擎与数据类型
    • MySQL 基础:库表、约束与类型
    • Java 集合:Vector 与 Stack
    • Java 集合:Vector 与 Stack
    • RabbitMQ:CentOS 7 单机部署
    • Redis:CentOS 7 单机部署
    • MongoDB:CentOS 7 单机部署
    • Linux:常用系统与运维命令
    • 注册中心:Eureka 与 ZooKeeper
    • MySQL:CentOS 7 单机部署
    • Git 分支:主分支与临时分支
    • CentOS 7:Java 开发环境部署
    • Java 集合:LinkedList 双向链表
    • Java 集合:ArrayList 动态数组
    • Spring AOP:注解方式实现切面
← 返回博客

Rust 基础:所有权机制

2021年11月27日 #后端开发 #Rust

Rust的核心功能之一 ownership ,运行的程序都需要使用计算机管理内存的方式,比如Java 具备垃圾回收,还有一些语言需要手动去释放内存。而Rust则是第三种方式,通过所有权管理内存,编译器在编译时会根据一些列规则检查,在运行时所有权系统的任务功能都不会减慢程序。

  • 所有权和生命周期是 Rust 和其它编程语言的主要区别,也是 Rust 其它知识点的基础。

所有权

栈

  • 栈是程序运行的基础。每当一个函数被调用时,一块连续的内存就会在栈顶被分配出来,这块内存被称为帧(frame)。

  • 栈以放入值的顺序存储并以相反的顺序取出值。这也被称为 后进先出 (last in , first out) 。添加数据的时候加 进栈 (pushing anto the stack) ,而移出数据叫 出栈 (poping off th stack)。

  • 在调用的过程中,一个新的帧会分配足够的空间存储寄存器的上下文。在函数里使用到的通用寄存器会在栈保存一个副本,当这个函数调用结束,通过副本,可以恢复出原本的寄存器的上下文,就像什么都没有经历一样。此外,函数所需要使用到的局部变量,也都会在帧分配的时候被预留出来。

  • 栈的操作时非常快的,这主要得益于它存取数据的方式,数据的存取位置总时在栈顶,而不需要重新寻找一个位置去存放或者读取。另一个属性就是,栈中所有的数据都必须占据已知且固定的大小。
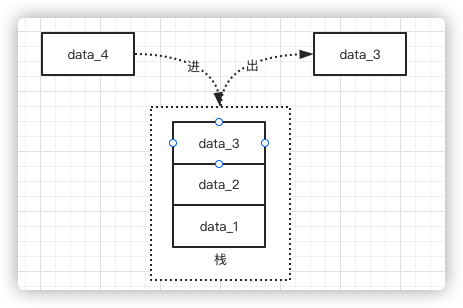
  • 但是工作中我们依然要避免大量数据存放栈中,避免栈溢出(stack overfow),运行程序调用栈超出了系统运行的最大空间,就无法创建新的帧。就会出现溢出现象。

堆

在编译时,一切无法确定大小或者大小可以改变的数据,都无法安全地放在栈上,最好放在堆上。

  • 堆主要存放大小未知,可能大小变化的数据,堆事缺乏组织的。当向堆中存放数据时,要申请一个空间,操作系统在堆的某处足够大的空间,把它标记为已经使用。并返回一个指针(pointer),这个过程叫做堆上分配内存(allocating on the heap)。
  • 访问堆上的数据比访问栈上的数据慢,因为必须通过指针来访问。现代处理器在内存中跳转越少就越快(缓存)。当代码调用一个函数时,传递给函数的值(包括可能指向堆上数据的指针)和函数的局部变量被压入栈中。当函数结束时,这些值被移出栈。

案例一

fn say(name : String){
	 println("name {}" , name);
}
say("tomcat".to_string());
say("jetty".to_string());
  • 字符串的数据结构,在编译器是不确定的,运行期才代码才知道大小。比如tomcat 和 jetty,当say方法执行的时候才知道参数的具体长度。

案例二

let mut arr = Vec::new();
arr.push(1);
arr.push(2);
  • 列表初始化长度是4,而不是2。在堆上内存分配会使用libc提供的mallo函数。系统调用的代价是昂贵的,所以我们要避免频繁地 malloc()。

内存泄漏

如果手工管理堆内存的话,堆上内存分配后忘记释放,就会造成内存泄漏。一旦有内存泄漏,程序运行得越久,就越吃内存,最终会因为占满内存而被操作系统终止运行。

堆越界

如果堆上内存被释放,但栈上指向堆上内存的相应指针没有被清空,就有可能发生使用已释放内存(use after free)的情况。

GC垃圾回收处理

  • 比如Java采用垃圾回收(GC),来自动管理内存,定期标记(mark)找出不在被引用的对象,然后清理(sweep)掉。
  • 但是GC是不确定的,可能引起STW(Stop The World)。

ARC自动引用计数处理方式

  • 在编译时,它为每个函数插入 retain/release 语句来自动维护堆上对象的引用计数,当引用计数为零的时候,release 语句就释放对象。

栈与堆

  • 栈上存放的数据是静态的,固定大小,固定生命周期;堆上存放的数据是动态的,不固定大小,不固定生命周期。

所有权规则

  • Rust中每一个值都有一个被称为其所有者的变量。
  • 值有且只有一个所有者。当所有者(变量)离开作用域,这个值将被丢弃。

作用域

变量作用域

{ // 作用域开启, var无效,未声明。
		let var = "hello";
		// 使用var 
} // 作用域结束, var不再有效。
  • 当变量var离开作用域的时候,Rust会调用一个特殊的函数drop自动处理。

    在 C++ 中,这种 item 在生命周期结束时释放资源的模式有时被称作 资源获取即初始化(Resource Acquisition Is Initialization (RAII))。

内存分配

定义某个变量且赋值,在编译期间就知道了具体内容。

案例一

let x = 5;	
let y = x;
  • 将x的值赋给y,这时候有了两个变量且值都等于5。此时栈中会存放两个5。

案例二

fn main() {
    println!("Hello, world!");
    let s1 = String::from("hi");
    let s2 = s1;
    println!("s1 value {}",s1);
    println!("s2 value {}",s2);
}
  • Console
--> src/main.rs:5:28
  |
3 |     let s1 = String::from("hi");
  |         -- move occurs because `s1` has type `String`, which does not implement the `Copy` trait
4 |     let s2 = s1;
  |              -- value moved here
5 |     println!("s1 value {}",s1);
  |                            ^^ value borrowed here after move
  • 编译器会提示两个错误,将s1 赋值给 s2 后 s1 就不能被访问了。
  • 如果还想让s1 被访问就需要 clone复制一份堆数据出来。
fn main() {
    println!("Hello, world!");
    let s1 = String::from("hi");
    let s2 = s1.clone();
    println!("s1 value {}",s1);
    println!("s2 value {}",s2);
}
  • Console
Hello, world!
s1 value hi
s2 value hi

Copy

Rust 有一个叫做 Copy trait 的特殊注解,可以用在类似整型这样的存储在栈上的类型上

  • 所有整数类型,比如 u32。
  • 布尔类型,bool,它的值是 true 和 false。 所有浮点数类型,比如 f64。
  • 字符类型,char。
  • Tuple元组,当且仅当其包含的类型也都是 Copy 的时候。比如,(i32, i32) 是 Copy 的,但 (i32, String) 就不是。

所有权与函数

将值传递给函数在语义上与给变量赋值相似。向函数传递值可能会移动或者复制,就像赋值语句一样。

案例


fn main() {
    let s = String::from("hi");    // s 进入作用域
    hello(s);                    
                                    // s 到这里不再有效
    let x = 5;                      // x 进入作用域
    hello_copy(x);                  // x 应该移动函数里,
                                    // 但 i32 是 Copy 的,所以在后面可继续使用 x
		println!("x {}", x);
} // 这里, x 先移出了作用域,然后是 s。但因为 s 的值已被移走,
  // 所以不会有特殊操作
fn hello(some_string: String) { // some_string 进入作用域
    println!("{}", some_string);
} // 移出作用域并调用 `drop` 方法。占用的内存被释放

fn hello_copy(some_integer: i32) { // 
    println!("{}", some_integer);
} // 移出作用域并调用 `drop` 方法。占用的内存被释放
  • Console
hi
5
x 5

返回值与作用域

返回值也可以转移所有权

案例

fn main() {
    let s1 = gives();              // gives_ownership 将返回值移给 s1
    println!("s1 {}",s1);
    let s2 = String::from("hello"); // s2 进入作用域
    println!("s2 {}",s2);
    let s3 = gives_back(s2);        // s2 gives_back 中,  它也将返回值移给 s3
    println!("s3 {}",s3);
} 
fn gives() -> String {             //  将返回值移动给
    let some_string = String::from("hello"); // some_string 进入作用域.
    some_string                              // 返回 some_string 并移出给调用的函数
}

fn gives_back(a_string: String) -> String { // a_string 进入作用域

    a_string  // 返回 a_string 并移出给调用的函数
}
  • Console
s1 hello
s2 hello
s3 hello

小结

栈只放大小已知且固定的数据,String 这类运行时才确定长度的值放在堆上并附指针;赋值 String 触发移动(move),原变量随即失效,报错 value borrowed here after move,需要共享时用 clone,而 i32、bool、char 及元素皆 Copy 的元组按值复制不受影响。

最近更新: 2026/11/20 22:16
Contributors: 庆峰
Prev
Rust 基础:第一个 CLI 程序
Next
Rust 基础:函数与控制流