本章是整理知识内容,为强化知识长期更新。
JVM
JVM 全称 Java Virtual Machine,也就是我们耳熟能详的 Java 虚拟机。JVM 会翻译执行 Java 字节码,然后调用真正的操作系统函数,这些操作系统函数是与平台息息相关的。
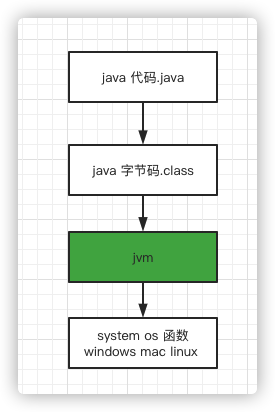
- 如上图所示,通过JVM,Java实现了跨平台、只要class文件能正常执行,就可以在其他系统上面运行。 JVM 与操作系统之间的关系:JVM 上承开发语言,下接操作系统,它的中间接口就是字节码。
JDK
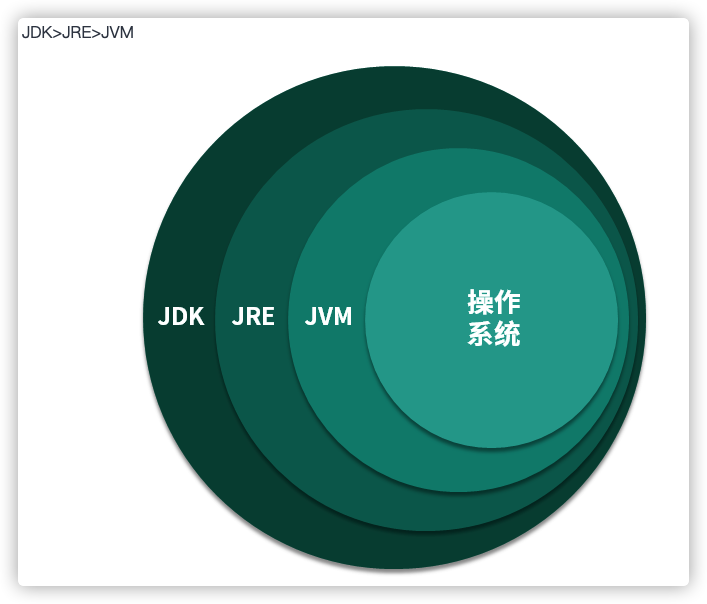
- JDK 的全拼,Java Development Kit JVM、JRE、JDK 它们三者之间的关系,可以用一个包含关系表示。
JVM字节码
对于 Java 开发者来说,虚拟机、字节码就是其底层知识。
Java Byte由单字节byte的指令组成,理论上最多支持256个操作码。实际上只使用了200个左右操作码。
编译java文件
这里采用xxd xx.java
package cn.z201.jvm;

public class Testing {

    public static void main(String[] args){
        System.out.println("Hello world!");
    }
}
- 通过javac编译成class文件、在用xxd查看编译后的16进制class文件。
➜  jvm git:(master) ✗ javac Testing.java
➜  jvm git:(master) ✗ xxd Testing.class
00000000: cafe babe 0000 0034 001d 0a00 0600 0f09  .......4........
00000010: 0010 0011 0800 120a 0013 0014 0700 1507  ................
00000020: 0016 0100 063c 696e 6974 3e01 0003 2829  .....<init>...()
00000030: 5601 0004 436f 6465 0100 0f4c 696e 654e  V...Code...LineN
00000040: 756d 6265 7254 6162 6c65 0100 046d 6169  umberTable...mai
00000050: 6e01 0016 285b 4c6a 6176 612f 6c61 6e67  n...([Ljava/lang
00000060: 2f53 7472 696e 673b 2956 0100 0a53 6f75  /String;)V...Sou
00000070: 7263 6546 696c 6501 000c 5465 7374 696e  rceFile...Testin
00000080: 672e 6a61 7661 0c00 0700 0807 0017 0c00  g.java..........
00000090: 1800 1901 000c 4865 6c6c 6f20 776f 726c  ......Hello worl
000000a0: 6421 0700 1a0c 001b 001c 0100 1363 6e2f  d!...........cn/
000000b0: 7a32 3031 2f6a 766d 2f54 6573 7469 6e67  z201/jvm/Testing
000000c0: 0100 106a 6176 612f 6c61 6e67 2f4f 626a  ...java/lang/Obj
000000d0: 6563 7401 0010 6a61 7661 2f6c 616e 672f  ect...java/lang/
000000e0: 5379 7374 656d 0100 036f 7574 0100 154c  System...out...L
000000f0: 6a61 7661 2f69 6f2f 5072 696e 7453 7472  java/io/PrintStr
00000100: 6561 6d3b 0100 136a 6176 612f 696f 2f50  eam;...java/io/P
00000110: 7269 6e74 5374 7265 616d 0100 0770 7269  rintStream...pri
00000120: 6e74 6c6e 0100 1528 4c6a 6176 612f 6c61  ntln...(Ljava/la
00000130: 6e67 2f53 7472 696e 673b 2956 0021 0005  ng/String;)V.!..
00000140: 0006 0000 0000 0002 0001 0007 0008 0001  ................
00000150: 0009 0000 001d 0001 0001 0000 0005 2ab7  ..............*.
00000160: 0001 b100 0000 0100 0a00 0000 0600 0100  ................
00000170: 0000 0500 0900 0b00 0c00 0100 0900 0000  ................
00000180: 2500 0200 0100 0000 09b2 0002 1203 b600  %...............
00000190: 04b1 0000 0001 000a 0000 000a 0002 0000  ................
000001a0: 0008 0008 0009 0001 000d 0000 0002 000e  ................
- 编译后完全看不懂,jdk实际上提供了专门用来解析类文件的工具
javap
javap
javap能对给定的class文件提供的字节代码进行反编译
- 使用格式
javap <options> <classes>

  -help  --help  -?        输出此用法消息
  -version                 版本信息
  -v  -verbose             输出附加信息
  -l                       输出行号和本地变量表
  -public                  仅显示公共类和成员
  -protected               显示受保护的/公共类和成员
  -package                 显示程序包/受保护的/公共类
                           和成员 (默认)
  -p  -private             显示所有类和成员
  -c                       对代码进行反汇编
  -s                       输出内部类型签名
  -sysinfo                 显示正在处理的类的
                           系统信息 (路径, 大小, 日期, MD5 散列)
  -constants               显示最终常量
  -classpath <path>        指定查找用户类文件的位置
  -cp <path>               指定查找用户类文件的位置
  -bootclasspath <path>    覆盖引导类文件的位置
- 演示下上面的类
javap -c -s -v Testing

Classfile /Users/z201/word/z201.github.io.code/java-learning/learn-jvm/src/test/java/cn/z201/jvm/Testing.class
  MD5 checksum b50deb6f6e7df9bb99585bc71b92d39b
  Compiled from "Testing.java"
public class cn.z201.jvm.Testing
  minor version: 0
  major version: 52
  flags: ACC_PUBLIC, ACC_SUPER
Constant pool:
   #1 = Methodref          #6.#15         // java/lang/Object."<init>":()V
   #2 = Fieldref           #16.#17        // java/lang/System.out:Ljava/io/PrintStream;
   #3 = String             #18            // Hello world!
   #4 = Methodref          #19.#20        // java/io/PrintStream.println:(Ljava/lang/String;)V
   #5 = Class              #21            // cn/z201/jvm/Testing
   #6 = Class              #22            // java/lang/Object
   #7 = Utf8               <init>
   #8 = Utf8               ()V
   #9 = Utf8               Code
  #10 = Utf8               LineNumberTable
  #11 = Utf8               main
  #12 = Utf8               ([Ljava/lang/String;)V
  #13 = Utf8               SourceFile
  #14 = Utf8               Testing.java
  #15 = NameAndType        #7:#8          // "<init>":()V
  #16 = Class              #23            // java/lang/System
  #17 = NameAndType        #24:#25        // out:Ljava/io/PrintStream;
  #18 = Utf8               Hello world!
  #19 = Class              #26            // java/io/PrintStream
  #20 = NameAndType        #27:#28        // println:(Ljava/lang/String;)V
  #21 = Utf8               cn/z201/jvm/Testing
  #22 = Utf8               java/lang/Object
  #23 = Utf8               java/lang/System
  #24 = Utf8               out
  #25 = Utf8               Ljava/io/PrintStream;
  #26 = Utf8               java/io/PrintStream
  #27 = Utf8               println
  #28 = Utf8               (Ljava/lang/String;)V
{
  public cn.z201.jvm.Testing();
    descriptor: ()V
    flags: ACC_PUBLIC
    Code:
      stack=1, locals=1, args_size=1
         0: aload_0
         1: invokespecial #1                  // Method java/lang/Object."<init>":()V
         4: return
      LineNumberTable:
        line 5: 0

  public static void main(java.lang.String[]);
    descriptor: ([Ljava/lang/String;)V
    flags: ACC_PUBLIC, ACC_STATIC
    Code:
      stack=2, locals=1, args_size=1
         0: getstatic     #2                  // Field java/lang/System.out:Ljava/io/PrintStream;
         3: ldc           #3                  // String Hello world!
         5: invokevirtual #4                  // Method java/io/PrintStream.println:(Ljava/lang/String;)V
         8: return
      LineNumberTable:
        line 8: 0
        line 9: 8
}
SourceFile: "Testing.java"
IDEA bytecode viewer
jclasslib is a bytecode viewer for Java class files
- 在plugins中搜索jclasslib bytecode viewer
- 安装重启IDEA后,编译项目代码(run 一次)选中代码文件 view 菜单中有 bytecode viewer 选项。
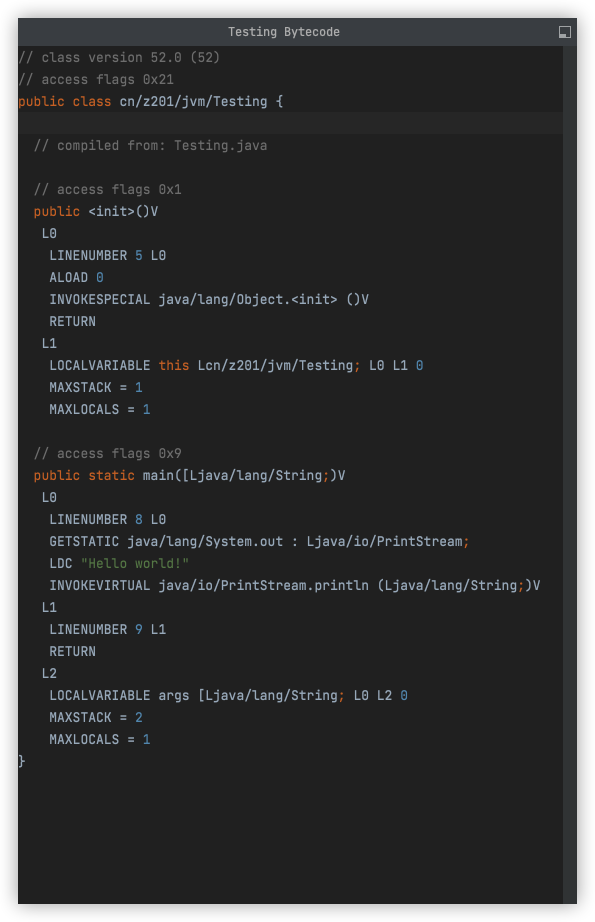
- IDEA 显示的内容更加容易阅读。
JVM的内存布局

堆
堆(Java Heap) 也叫 Java 堆或者是 GC 堆,它是一个线程共享的内存区域,也是 JVM 中占用内存最大的一块区域,Java 中所有的对象都存储在这里。
存储的是我们new来的对象,不存放基本类型和对象引用。
由于创建了大量的对象,垃圾回收器主要工作在这块区域。
线程共享区域,因此是线程不安全的。
能够发生内存溢出,主要有OutOfMemoryError和StackOverflowError。
那么什么时候发生OutOfMemoryError,什么时候发生StackOverflowError?虚拟机在扩展栈时无法申请到足够的内存空间,将抛出OutOfMemoryError异常,线程请求的栈深度超过虚拟机所允许的最大深度,将抛出StackOverflowError异常。
Java堆区还可以划分为新生代和老年代,新生代又可以进一步划分为Eden区、Survivor 1区、Survivor 2区。具体比例参数的话,可以看一下下面这张图。

- 合理设置老年代和新生代的空间比例对 JVM 垃圾回收的性能有很大影响,JVM 设置老年代新生代比例的参数是 -XX:NewRatio。
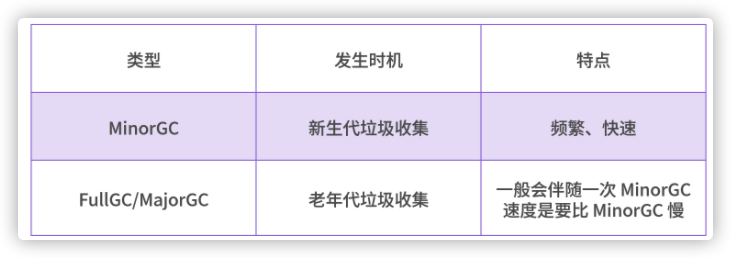
Minor GC 发生在新生代,而 Full GC 发生在老年代。
大部分新生成的对象都是在 Eden 区,Eden 区满了之后便没有内存给新对象使用,Eden 区便会 Minor GC 回收无用内存,剩下的存活对象便会转移到 Survivor 区。
从 Eden 区存活下来的对象首先会被复制到 From 区,当 From 区满时,此时还存活的对象会被转移到 To 区,经历了多次的 Minor GC 后,还存活的对象就会被复制到老年代,老年代的 GC 一般叫作 FullGC 或者 MajorGC。
新生代
- 新生代是类的诞生、成长、消亡的区域,一个类在这里产生、应用,最后被垃圾回收器收集,结束生命。新生区又分为两部分:伊甸区(Eden space)和幸存区(Survivor pace),绝大多数的类都是在伊甸区被 new 出来的。幸存区有两个:0区(from Survivor 0 space)和 1区(to Survivor 1 space)。两个Survivor 区空间一样大,当Eden 区满了,则会触发普通GC,若 Eden 区中的对象经过垃圾回收没有被回收掉,会将Eden 区中的幸存对象移动到幸存0区。若幸存0区也满了,再对该区域进行垃圾回收,然后移动到1区,然后之前的0区将置为空,没有任何数据。显然,Survivor 区只是增加了对象在年轻代中逗留的时间,增加了被垃圾回收的可能性。那如果1区也满了呢?再移动到养老区。若养老区也满了,那么这时候将产生Full GC,进行养老区的内存清理。若养老区执行Full GC 之后发现依然无法进行对象的保存,就会产生 OOM 异常“OutOfMemoryError”。
- 每次垃圾回收时都有大量的对象需要被回收。垃圾回收器在新生代采用的收集算法是Copying(复制)方法:它将可用内存按容量划分为大小相等的两块,每次只使用其中的一块。当这一块面对内存用完了,就将还存活的对象复制到另外一块,然后再把已使用的内存空间一次清理掉。由于新生代有每次垃圾回收时都有大量的对象需要被回收的特点,所以采用Copying算法,复制的存活对象较少,性能比较好。但是Copying算法还是有缺陷的,那就是内存的使用率只有一半。
OutOfMemoryError
java.lang.OutOfMemoryError: Java heap space
Java 虚拟机的堆内存设置不够,可以通过-Xms、-Xmx来调整
代码中创建了大量大对象,并且长时间不能被垃圾回收器收集
内存加载的数据量太大:一次性从数据库取太多数据
集合类中有对对象的引用,使用后未清空,GC不能进行回收
代码中存在循环产生过多的重复对象
老年代
- 年轻代中经过垃圾回收没有回收掉的对象将被Copy到年老代。
- 每次垃圾回收时只有少量的对象需要被回收。垃圾回收器在老年代采用的收集算法是 Mark-Compact 算法:为了解决Copying算法的缺陷,充分利用内存空间,提出了Mark-Compact算法。它先将需要回收的对象进行标记,然后将存活对象都向一端移动,然后清理掉端边界以外的内存。
FULL GC
- 当老年代空间满了,就会对新生代和老年代空间进行一次全量垃圾回收,即Full GC。
方法区
- 方法区(Method Area) 也被称为非堆区,用于和“Java 堆”的概念进行区分,它也是线程共享的内存区域,用于存储已经被 JVM 加载的类型信息、常量、静态变量、代码缓存等数据。
运行时常量池
- Run-Time Constant Pool这是方法区的一部分,版本号、字段、方法、超类、接口等各种信息,还有一项信息就是常量池。Java 的常量池可以存放各种常量信息,不管是编译期生成的各种字面量,还是需要在运行时决定的符号引用。
程序计数器
- 程序计数器(Program Counter Register) 线程独有一块很小的内存区域,保存当前线程所执行字节码的位置,包括正在执行的指令、跳转、分支、循环、异常处理等。
虚拟机栈
- 虚拟机栈也叫 Java 虚拟机栈(Java Virtual Machine Stack),和程序计数器相同它也是线程独享的,用来描述 Java 方法的执行,在每个方法被执行时就会同步创建一个栈帧,用来存储局部变量表、操作栈、动态链接、方法出口等信息。当调用方法时执行入栈,而方法返回时执行出栈。
线程私有区域,每一个线程都有独享一个虚拟机栈,因此这是线程安全的区域。
存放基本数据类型以及对象的引用。
每一个方法执行的时候会在虚拟机栈中创建一个相应栈帧,方法执行完毕后该栈帧就会被销毁。方法栈帧以先进后出的方式管理虚拟机栈。
每一个栈帧又可以划分为局部变量表、操作数栈、动态链接、方法出口以及额外的附加信息。
- 这个区域可能有两种异常:如果线程请求的栈深度大于虚拟机所允许的深度,将抛出StackOverflowError异常(通常是递归导致的);JVM动态扩展时无法申请到足够内存则抛出OutOfMemoryError异常。
本地方法栈
本地方法栈(Native Method Stacks)与虚拟机栈类似,它是线程独享的,并且作用也和虚拟机栈类似。只不过虚拟机栈是为虚拟机中执行的 Java 方法服务的,而本地方法栈则是为虚拟机使用到的本地(Native)方法服务。
JVM 的执行流程是,首先先把 Java 代码(.java)转化成字节码(.class),然后通过类加载器将字节码加载到内存中,所谓的内存也就是我们上面介绍的运行时数据区,但字节码并不是可以直接交给操作系统执行的机器码,而是一套 JVM 的指令集。这个时候需要使用特定的命令解析器也就是我们俗称的**执行引擎(Execution Engine)**将字节码翻译成可以被底层操作系统执行的指令再去执行,这样就实现了整个 Java 程序的运行,这也是 JVM 的整体执行流程。
类的加载机制
符号引用和直接引用有一个重要的区别:使用符号引用时被引用的目标不一定已经加载到内存中;而使用直接引用时,引用的目标必定已经存在虚拟机的内存中了。
- 类的生命周期会经历以下 7 个阶段:
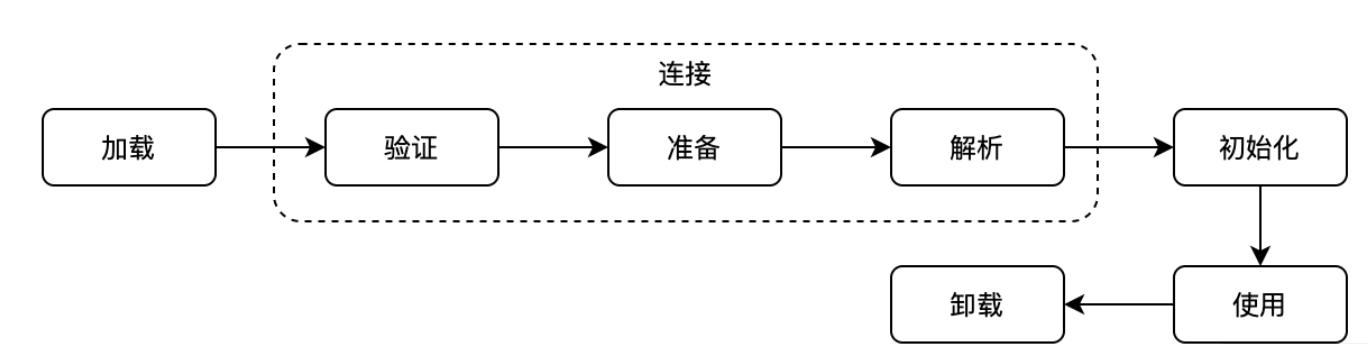
- 加载阶段(Loading)
- 验证阶段(Verification)
- 准备阶段(Preparation)
- 解析阶段(Resolution)
- 初始化阶段(Initialization)
- 使用阶段(Using)
- 卸载阶段(Unloading)
加载阶段
此阶段用于查到相应的类(通过类名进行查找)并将此类的字节流转换为方法区运行时的数据结构,然后再在内存中生成一个能代表此类的 java.lang.Class 对象,作为其他数据访问的入口。
- Java语言的类型可以分为两大类:基本类型、引用类型。基本类型是由虚拟机预先定义好的,所以不会经历单独的类加载过程。而引用类型又分为四种:类、接口、数组类、泛型参数。由于泛型参数会在编译的过程中被擦除(关于类型擦除的知识,大家可以查下资料),所以在Java中只有类、接口、数组类三种类型需要经历JVM对其进行连接和初始化的过程。
验证阶段
此步骤主要是为了验证字节码的安全性,如果不做安全校验的话可能会载入非安全或有错误的字节码,从而导致系统崩溃,它是 JVM 自我保护的一项重要举措。
- 验证的主要动作大概有以下几个:
- 文件格式校验包括常量池中的常量类型、Class 文件的各个部分是否被删除或被追加了其他信息等;
- 元数据校验包括父类正确性校验(检查父类是否有被 final 修饰)、抽象类校验等;
- 字节码校验,此步骤最为关键和复杂,主要用于校验程序中的语义是否合法且符合逻辑;
- 符号引用校验,对类自身以外比如常量池中的各种符号引用的信息进行匹配性校验。
准备阶段
此阶段是用来初始化并为类中定义的静态变量分配内存的,这些静态变量会被分配到方法区上。这些变量所使用的内存都将在方法区(<Jdk1.8)元数据区(>=Jdk1.8)中进行分配。这时候进行内存分配的仅包括类变量,而不包括实例变量,实例变量将会在对象实例化的时候随对象一起分配在Java堆中。
解析阶段
此阶段主要是用来解析类、接口、字段及方法的,解析时会把符号引用替换成直接引用。
所谓的符号引用是指以一组符号来描述所引用的目标,符号可以是任何形式的字面量,只要使用时能无歧义地定位到目标即可;而直接引用是可以直接指向目标的指针、相对偏移量或者是一个能间接定位到目标的句柄。
符号引用和直接引用有一个重要的区别:使用符号引用时被引用的目标不一定已经加载到内存中;而使用直接引用时,引用的目标必定已经存在虚拟机的内存中了。
初始化
初始化阶段 JVM 就正式开始执行类中编写的 Java 业务代码了。到这一步骤之后,类的加载过程就算正式完成了。
- JVM 规范枚举了下述多种触发情况:
- 当虚拟机启动时,初始化用户指定的主类;
- 当遇到用以新建目标类实例的 new 指令时,初始化 new 指令的目标类;
- 当遇到调用静态方法的指令时,初始化该静态方法所在的类;
- 当遇到访问静态字段的指令时,初始化该静态字段所在的类;子类的初始化会触发父类的初始化;
- 如果一个接口定义了 default 方法,那么直接实现或者间接实现该接口的类的初始化,会触发该接口的初始化;
- 使用反射 API 对某个类进行反射调用时,初始化这个类;
- 当初次调用 MethodHandle 实例时,初始化该 MethodHandle 指向的方法所在的类。
- 当虚拟机启动时,初始化用户指定的主类;
Jvm垃圾回收
- JVM可以自动管理内存,拥有自动垃圾回收机制,主要是对堆中的对象进行清理。
可达性分析算法
从线程栈帧中局部变量或者方法区的静态变量引用的对象进行标记,然后判断被标记的对象是否引用了其他对象,通过持续标记。找出未被标记的对象,这些对象就是可以被回收的垃圾对象。
回收方式
清理
- 将垃圾对象占用用的空间标记成空闲,记录在空闲队列中,当需要分配新对象的时候,就从空闲队列中找到合适的空间分配给这个对象。但是垃圾对象是散落在内存空间各处,并不是连续存放的。当需要分配一段连续大的内存空间的时候,可能出现没有足够空闲空间的问题。

压缩
- 从堆空间的头部开始,将存活的对象拷贝在一段连续的内存空间中,剩余的空间就是连续的空闲空间。

复制
- 将堆空间拆分成2空间from、to,其中一部分创建对象,当from空间对象使用完成后,将标记过的对象复制到to空间中,当对象从from复制到to空间后,两个空间交换引用,继续在from空间创建对象,一直到from空间满了。这里的空闲是指标记空闲。

垃圾回收器
具体执行垃圾回收的回收器有四种,

Serial
- 早期的垃圾回收器只有一个线程执行垃圾回收。
Parallel
- 多个线程执行垃圾回收,适合在多核cpu上面,在串行或者并行垃圾回收过程中,需要停止用户程序线程,或者可能导致对象标记错乱。对用户程序影响较大,程序都停止了。
CMS
- 在垃圾回收的阶段,垃圾回收器和用户线程可以并发执行,对程序线程影响较小。
G1
- 将堆拆分成多个子区域,每个区域独自进行垃圾回收。整个过程垃圾回收线程和用户程序线程并行。效率较高适合多种场景。
类加载器
虚拟机设计团队把加载动作放到 JVM 外部实现,以便让应用程序决定如何获取所需的类,JVM 提供了 3 种类加载器:

BootstrapClassloader 启动(根)类加载器
- 它不是java类,该类加载器由C++实现,它嵌套在JVM内核里,当JVM启动时该类加载器就启动了。负责加载Java基础类,对应加载的文件是JRE/lib/ 目录下的rt.jar、resources.jar、charsets.jar等。
ExtensionClassLoader 扩展类加载器
- 加载JRE/lib/ext下面指定要用的jar包,继承URLClassLoader。
AppClassLoader 应用程序类加载器
- 加载应用程序classpath目录下的所指定的类库,继承URLClassLoader。
自上而下尝试加载,最下面的加载器没有加载到的话,则抛出ClassNotFoundException。
- 如果一个类加载器收到了类加载请求,它并不会自己先去加载,而是把这个请求委托给父类的加载器去执行;
- 如果父类加载器还存在其父类加载器,则进一步向上委托,依次递归,请求最终将到达顶层的启动类加载器;
- 如果父类加载器可以完成类加载任务,就成功返回,倘若父类加载器无法完成此加载任务,子加载器才会尝试自己去加载,
双亲委派机制
- 这种工作原理就是双亲委派机制。Java类随着加载它的类加载器一起具备了一种带有优先级的层次关系。比如,Java中的Object类,它存放在rt.jar之中,无论哪一个类加载器要加载这个类,最终都是委派给处于模型最顶端的启动类加载器进行加载,因此Object在各种类加载环境中都是同一个类。如果不采用双亲委派模型,那么由各个类加载器自己去加载的话,那么系统中会存在多种不同的Object类。
- 避免核心API被篡改。
- 避免类的重复加载。
- 子类加载器可以访问父加载器的类型,但是反过来不行。由于父加载器的类型对于子加载器是可见的,所以父加载器中加载的类型不会在子加载器中重复加载。
负责依赖
- 如果一个加载器在加载某个类的时候,发现这个类依赖于另外几个类或接口,也会去尝试加载这些依赖项。
缓存加载
- 为了提升加载效率,消除重复加载,一旦某个类被一个类加载器加载,那么它会缓存这个加载结果,不会重复加载。
JVM 调优
默认参数无法发挥程序性能时才需要调优:调优的目标是在更少的内存与停顿下获得更高吞吐。
什么时候需要调优
- 堆内存(老年代)持续上涨,达到设置的最大值。
- Full GC 次数频繁。
- GC 停顿时间过长,超过 1 秒。
- 应用出现 OutOfMemory 等内存异常。
- 应用中使用本地缓存且占用大量内存。
- 系统吞吐量与响应性能不高或持续下降。
调优顺序
- 上线前先把 JVM 启动参数设置到合适值。
- 大多数 GC 问题源于代码:减少创建对象、减少全局变量与大对象。
- 优先做架构调优和代码调优,JVM 参数是最后手段。
- 分析 GC 情况后优化代码,比直接调 JVM 参数更有效。
启动参数
调优的最终目的是让应用用最小的硬件消耗承载更大的吞吐量:
- 延迟:GC 低停顿、低频率。
- 低内存占用。
- 高吞吐量。
- 堆内存 = Old + Eden + S0 + S1;新生代 = Eden + S0 + S1。
JVM 参数分三类:
- 标准参数(
-):所有 JVM 实现都必须支持,向后兼容。 - 非标准参数(
-X):默认实现支持,但不保证所有 JVM 实现都满足,也不保证向后兼容。 - 非稳定参数(
-XX):各 JVM 实现可能不同,未来可能不再支持,使用需谨慎。
一组常见配置:
-XX:MetaspaceSize=128m -XX:MaxMetaspaceSize=128m -Xms1024m -Xmx1024m -Xmn256m -Xss256k -XX:SurvivorRatio=8 -XX:+UseConcMarkSweepGC
各参数含义:
-XX:MetaspaceSize=128m (元空间初始大小)
-XX:MaxMetaspaceSize=128m (元空间最大大小)
-Xms1024m (堆初始大小)
-Xmx1024m (堆最大大小)
-Xmn256m (新生代大小)
-Xss256k (栈最大深度大小)
-XX:SurvivorRatio=8 (新生代分区比例 8:2)
-XX:+UseConcMarkSweepGC (指定垃圾收集器,这里使用 CMS)
-XX:+PrintGCDetails (打印详细 GC 日志)
调优的参考线:堆内存使用率不超过 70%,老年代使用率不超过 70%,单次 GC 平均停顿不超过 1 秒,Full GC 次数为 0 或间隔不少于 24 小时。
- 建议
-Xms取最大内存的 0.6 至 0.8 倍,并留出系统自身的内存开销。 - 堆内存必须是 1024 的倍数,且不低于 2 MB;32 位机器上限约 1 GB,64 位机器可以更大。
- 堆外内存一般指 Direct Memory,不受 GC 控制,JVM 与 Netty 都可能使用,可用
-XX:MaxDirectMemorySize限制。
当不确定某个参数的含义时,可以输出当前 JVM 支持的全部参数:
java -XX:+PrintFlagsFinal -XX:+UnlockDiagnosticVMOptions -version | wc -l
openjdk version "1.8.0_275"
OpenJDK Runtime Environment (AdoptOpenJDK)(build 1.8.0_275-b01)
OpenJDK 64-Bit Server VM (AdoptOpenJDK)(build 25.275-b01, mixed mode)
     838
内存分配与 GC 的关系
- 在特定业务场景下,内存分配不合理带来的性能损耗不像内存溢出那样明显,不深入指标很难发现。
- 最直接的表现是频繁 GC,进而引发上下文切换,降低吞吐量、拉长响应时间。
分析 GC 日志
压测时需要同时开启 GC 日志:
-XX:+PrintGCTimeStamps -XX:+PrintGCDetails -Xloggc:/log/heap.log
-XX:+PrintGCTimeStamps:打印 GC 发生的具体时间。-XX:+PrintGCDetails:打印 GC 详细日志。-Xloggc:path:指定 GC 日志文件路径。
JVM 内存调优与 GC 调优互补,在确定堆与新生代大小后,再针对垃圾回收算法继续调整。
扩展
你将如何使用thread dump?你将如何分析Thread dump
- 线程转储是一个JVM活动线程的列表,它对于分析系统瓶颈和死锁非常有用。有很多方法可以获取线程转储——使用Profiler,Kill -3命令,jstack工具等等。我更喜欢jstack工具,因为它容易使用并且是JDK自带的。由于它是一个基于终端的工具,所以我们可以编写一些脚本去定时的产生线程转储以待分析。
Java中堆和栈有什么不同
- 栈是⼀块和线程紧密相关的内存区域,每个线程都有⾃⼰的栈内存,⽤于存储本地变量,⽅法参数和栈调⽤,⼀个线程中存储的变量对其它线程是不可⻅的。
- 堆是所有线程共享的⼀⽚公⽤内存区域,对象都在堆⾥创建,为了提升效率线程会从堆中弄⼀个缓存到⾃⼰的栈,如果多个线程使⽤该变量就可能引发问题,这时volatile 变量就可以发挥作⽤了,它要求线程从主存中读取变量的值。
内存泄漏和内存溢出
- 内存溢出是说程序需要申请的内存超过了JVM当前可以分配的最大内存,溢出。
- 内存泄漏是说期望被回收的内存对象没有被回收,泄漏。
- 内存泄漏持续发生,很可能引起内存溢出。
查看GC频次
如果是JDK自带的工具,可以使用jstat查看GC频次。
小结
从 class 文件头与 javap 反汇编切入,讲堆、方法区、栈等区域、类加载七阶段与双亲委派;调优先改代码,再按 -Xms、-Xmx、-Xmn 配堆,压测时用 -Xloggc 分析 GC 日志。