系列文章:MySQL:架构、事务与优化 的第 2 篇。
事务
事务(Transaction)是并发控制的基本单位。所谓的事务,它是一个操作序列,这些操作要么都执行,要么都不执行,它是一个不可分割的工作单位。事务是数据库维护数据一致性的单位,在每个事务结束时,都能保持数据一致性。
ACID
一说到 MySQL 事务,你肯定能想起来四大特性:
原子性、一致性、隔离性、持久性。ACID模式是一组数据库设计原则强调的是,对于业务数据和关键任务应用重要的可靠性方面。MySQL包含诸如的组件
InnoDB存储引擎与ACID模型紧密结合,因此数据不会损坏,并且不会因软件崩溃和硬件故障等特殊情况而导致结果失真。当您依赖符合ACID的功能时,您无需重新发明一致性检查和崩溃恢复机制。如果您有其他软件安全措施,超可靠硬件或可以容忍少量数据丢失或不一致的应用程序,您可以调整MySQL设置以交换一些ACID可靠性以获得更高的性能或吞吐量。
原子性(Atomicity)
- 原子性指的就是 MySQL 中的包含事务的操作要么
全部成功、要么全部失败回滚,因此事务的操作如果成功就必须要全部应用到数据库,如果操作失败则不能对数据库有任何影响。
一致性(Consistency)
- 一致性指的是一个事务在执行前后其状态一致。比如 A 和 B 加起来的钱一共是 1000 元,那么不管 A 和 B 之间如何转账,转多少次,事务结束后两个用户的钱加起来还得是 1000,这就是事务的一致性。
持久性(Durability)
- 持久性指的是一旦事务提交,那么发生的改变就是永久性的,即使数据库遇到特殊情况比如故障的时候也不会产生干扰。
隔离性(Isolation)
当多个事务同时进行时,就有可能出现
脏读(dirty read)、不可重复读(non-repeatable read)、幻读(phantom read)的情况,为了解决这些并发问题,提出了隔离性的概念。
读未提交:读未提交指的是一个事务在提交之前,它所做的修改就能够被其他事务所看到。读已提交:读已提交指的是一个事务在提交之后,它所做的变更才能够让其他事务看到。可重复读:可重复读指的是一个事务在执行的过程中,看到的数据是和启动时看到的数据是一致的。未提交的变更对其他事务不可见。串行化:顾名思义是对于同一行记录,写会加写锁,读会加读锁。当出现读写锁冲突的时候,后访问的事务必须等前一个事务执行完成,才能继续执行。
隔离性四个特性
最重要的就是一致性。而一致性由原子性,隔离性,持久性来保证。
- 原子性由 Undo log 保证。Undo Log 会保存每次变更之前的记录,从而在发生错误时进行回滚。
- 隔离性由 MVCC 和 Lock 保证。
- 持久性由 Redo Log 保证。每次真正修改数据之前,都会将记录写到 Redo Log 中,只有 Redo Log 写入成功,才会真正的写入到 B+ 树中,如果提交之前断电,就可以通过 Redo Log 恢复记录。
| 事务隔离级别 | 值 | 脏读 | 不可重复读 | 幻读 |
|---|---|---|---|---|
| 读未提交(read-uncommitted) | 1 | 是 | 是 | 是 |
| 读已提交(read-committed) | 2 | 否 | 是 | 是 |
| 可重复读(repeatable-read) | 3 | 否 | 否 | 是(x) |
| 串行化(serializable) | 4 | 否 | 否 | 否 |
读已提交和可重复读实现原理就是MVCC Read View不同的生成时机。可重复读只在事务开始时生成一个Read View;读已提交每次执行前都会生成Read View。
事物带来的问题
- 更新丢失
- 解决:让事务变成串行操作,而不是并发的操作,即对每个事务开始---对读取记录加排他锁
- 脏读
- 解决:隔离级别为Read uncommitted
- 不可重复读
- 解决:使用Next-Key Lock算法来避免
- 幻读
- 解决:间隙锁(Gap Lock)
读未提交
一个事物未提交的时候,它做的数据变更就能被其它事物看到。
- 原理:直接读取数据,不能解决任何并发问题
读提交
一个事物提交后,它做的数据变更才能被其它事物看到。
- 原理:利用MVCC实现,每一句语句执行前都会生成Read View(一致性视图)
可重复读 (默认隔离级别)
一个事物执行的过程中看到的数据,总是跟这个事物在启动时候看的数据一致。只有事务开始时会创建Read View,之后事务里的其他查询都用这个Read View。解决了脏读、不可重复读,快照读(普通查询,读取历史数据)
- 原理:使用MVCC解决了幻读,当前读(读取最新提交数据)通过间隙锁解决幻读(lock in share mode、for update、update、detete、insert),间隙锁在可重复读下才生效。
串行化
对同一行数据
写会加写锁,读会加读锁。当出现读写冲突的时候,必须按数据执行事务。
- 原理:使用锁,读加共享锁,写加排他锁,串行执行
并发事务的问题
脏读
一个事务正在对一条记录进行修改,在这个事务完成并提交前,这条记录的数据就处于不一致状态。这时,另一个事务也来读取同一条记录,如果不加控制,第二个事务读取了这些“脏”数据,并据此做进一步的处理,就会产生未提交的数据依赖关系。
| 时间 | 事务A | 事务B |
|---|---|---|
| T1 | 开启事务 | 开启事务 |
| T2 | 查询账户余额为1000 | |
| T3 | 充值500,余额修改为1500 | |
| T4 | 查询余额为1500 | |
| T5 | 撤销事务,余额改回1000 | |
| T6 | 汇入500,余额修改为2000 | |
| T7 | 提交事务 |
不可重复读
一个事务在读取某些数据后的某个时间,再次读取以前读过的数据,却发现其读出的数据已经发生了变更、或者某些记录已经被删除了。
| 时间 | 事务A | 事务B |
|---|---|---|
| T1 | 开启事务 | 开启事务 |
| T2 | select * from user where user_id=100 假设为小明的用户信息 | |
| T3 | 将user_id=100的用户信息对应的年龄修改为18 | |
| T4 | 提交事务 | |
| T5 | 再次查询发现用户的年龄变更了 | |
| T6 | ... | |
| T7 | 提交事务 |
幻读
一个事务按相同的查询条件重新读取以前检索过的数据,却发现其它事务插入了满足其查询条件的新数据。
| 时间 | 事务A | 事务B |
|---|---|---|
| T1 | 开启事务 | 开启事务 |
| T2 | select * from user where age=18 假设得到两条记录 | |
| T3 | 向user表插入一条age=18的新记录 | |
| T4 | 提交事务 | |
| T5 | 再次查询得到三条记录 | |
| T6 | .. | |
| T7 | 提交事务 |
- 在RC可重复读隔离级别下
- 普通的查询是快照读,是不会看到其它事物插入的数据.
- 在RR隔离级别下间隙锁才有效果,RC隔离级别下并没有间隙锁。
- RR隔离级别下,快照读依然靠MVCC版本控制,当前读通过间隙锁解决。
- 为了解决幻读,可以采用读一提交,间隙锁是在可重复读隔离级别下才生效。但是也需要解决数据与日志不一致的问题。需要吧binglog格式设置成row。也就是说RC隔离级别+binglog_format_row的组合。
幻读和不可重复读的区别
- 不可重复读的重点是修改:在同一事务中,相同的条件,第一次和第二次读到的数据不一致(中间有其它事务提交了修改)。
- 幻读的重点是新增或者删除:在同一事务中,相同的条件,第一次和第二次读到的记录数不一样(中间有其它事务提交了新增或者删除)。
LOCK
这很重要不管是面试工作,还是排查异常,出现问题的时候需要发现、定位、解决能力。也是开发人员必须掌握的一项能力。
理解下锁几种维度
类型维度
共享锁
- 读锁(read lock),也叫共享锁(shared lock)(读锁 / S 锁)针对同一份数据,多个读操作可以同时进行而不会互相影响(select)
排它锁(写锁 / X 锁)
写锁(write lock),也叫排他锁(exclusive lock)当前操作没完成之前,会阻塞其它读和写操作(update、insert、delete)
意向共享锁(IS)
- 一个事务给一个数据行加共享锁时,必须先获得表的IS锁
意向排他(互斥)锁(IX)
- 一个事务给一个数据行加排他锁时,必须先获得该表的IX锁
悲观锁(使用锁,即 for update)
乐观锁(使用版本号字段,类似 CAS 机制,即用户自己控制。缺点:并发很高的时候,多了很多无用的重试)
锁的粒度(粒度维度)
表锁
- 对整张表加锁;开销小、加锁快、无死锁、锁粒度大,发生锁冲突概率大,并发性极低。
页锁(Mysql BerkeleyDB 引擎)
- 开销、加锁时间和锁粒度介于表锁和行锁之间,会出现死锁,并发处理能力一般。开发基本不用。
行锁(InnoDB)
- 允许一个事务去读一行,阻止其他事务获得相同数据集的排他锁。
- 对一行数据加锁;开销大、加锁慢、会出现死锁、锁力度小、发送锁冲突较低,并发性适中。
全剧锁 (锁的是整个
database)全库备份的时候时全局锁
锁的算法(算法维度)
- Record Lock(单行记录)
- Gap Lock(间隙锁,锁定一个范围,但不包含锁定记录)
- Next-Key Lock(Record Lock + Gap Lock,锁定一个范围,并且锁定记录本身, MySql 防止幻读,就是使用此锁实现)
加锁方式
- 表锁隐式加锁
select # 隐式上读锁
insert update delete # 隐式上写锁
- 表锁显式加锁
lock table talbeName read; # 表加读锁
lock table tableName write; # 表加写锁
unlock tables; # 解锁所有表
- 行锁隐式加锁
insert update delete # 隐式上写锁
- 行锁显式加锁
select * from tableName in share mode; # 读锁
select * from tableName for update; # 写锁
# 注意事项
# 1.如果写锁加锁的字段没有建立索引,会变成表锁。
# 2.在多并行事物的情况下,上了写锁,其他事物是可以读数据。在InnoDB上有MVCC机制(多版本控制),其他事物读取的其实是undo日志,在事物提交之前Undo Log保存了未提交的版本数据,Undo log 中的数据可以作为数据旧版本提供快照读,且为其他事物提供快照读。并且该操作并不会阻塞。
- 行锁显式解锁
commit # 提交事物
rollback # 回滚事物
kill # 阻塞
Record Lock
对单个记录加锁,行锁只有在事务结束的时候才会释放。也就时两阶段协议完成后。
## 对id=3的记录加S型Record Lock S锁
SELECT * FROM `usr_info` WHERE id = 3 LOCK IN SHARE MODE;
## 对id=3的记录加S型Record Lock x锁
SELECT * FROM `usr_info` WHERE id = 3 FOR UPDATE;
Gap Lock
锁住记录前面的间隙,不允许插入记录
##不允许别的事务在id=3的记录前面的间隙插入新记录,即id值在(1, 3)这个区间内的记录是不允许立即插入的。直到加间隙锁的事务提交后,id值在(1, 3)这个区间中的记录才可以被提交。
SELECT * FROM `usr_info` WHERE id < 3 AND id > 1 LOCK IN SHARE MODE;
# 解决了事物并发幻读的问题,如果锁的范围很大,对性能影响很大。
Next-Key Lock
同时锁住数据和数据前面的间隙,即数据和数据前面的间隙都不允许插入记录
-- 对id=3的聚集索引记录加S型Record Lock
-- 对id>1的所有聚集索引记录加S型Next-key Lock(包括Supremum伪记录)
SELECT * FROM `usr_info` WHERE id <= 3 AND id > 1 LOCK IN SHARE MODE;
- 未加索引的字段
只有通过索引条件检索数据时,InnoDB才会使用行级锁,否则会使用表级锁(索引失效,行锁变表锁)
- 每个间隙锁是前开后闭区间。间隙锁语句同样能会锁定大量范围,影响并发速度。
行锁查询
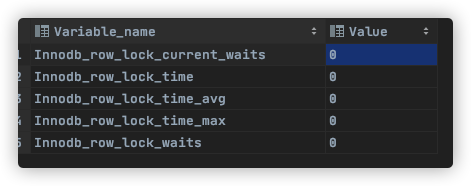
show status like 'innodb_row_lock%';
#innodb_row_lock_current_waits //当前正在等待锁定的数量
#innodb_row_lock_time //从系统启动到现在锁定总时间长度
#innodb_row_lock_time_avg //每次等待所花平均时间
#innodb_row_lock_time_max //从系统启动到现在等待最长的一次所花时间
#innodb_row_lock_waits //系统启动后到现在总共等待的次数
- 行锁使用建议
- 尽可能让所有数据检索都通过索引来完成,避免无索引行锁升级为表锁。
- 合理设计索引,尽量使用小范围的锁。
- 避免长事物,占用大量资源。
乐观锁与悲观锁
数据库通过锁机制来解决并发场景-共享锁(读锁)和排他锁(写锁)。读锁是不阻塞的,多个客户端可以在同一时刻读取同一个资源。写锁是排他的,并且会阻塞其他的读锁和写锁。简单提下乐观锁和悲观锁。
悲观锁:假定会发生并发冲突,屏蔽一切可能违反数据完整性的操作。
- 表锁,锁定整张表,开销最小,但是会加剧锁竞争。
- 行锁,锁定行级别,开销最大,但是可以最大程度的支持并发。
- 共享锁(多个事物共享)共享锁也叫读锁或 S 锁。
- 排它锁(单个事物占有)排它锁也独占锁、写锁或 X 锁
乐观锁:假设不会发生并发冲突,只在提交操作时检查是否违反数据完整性。
- 不过通过数据库的版本机制实现,通过版本号字段或者时间戳字段来实现。
死锁
在并发系统中出现不同线程循环依赖资源,涉及的线程都在等待其他线程释放资源,就会导致相关线程进入无限等待的状态,简称死锁。
ERROR 1213 (40001): Deadlock found when trying to get lock; try restarting transaction
- 检查死锁
show engine innodb status - 设置超时时间,防止线程事务一直等待。
innodb_lock_wait_timeout设置超时时间,该值默认的时间时50s。 - 主动回滚相关线程中某个事物,
show processlist手动释放资源kill pid。
InnoDB引擎的行锁的实现方式
InnoDB是基于索引来完成行锁
-- 例:  --
select * from tab_with_index where id = 1 for update;
-- for update 可以根据条件来完成行锁锁定,并且 id 是有索引键的列--
-- 如果 id 不是索引键那么InnoDB将完成表锁,并发将无从谈起--
InnDb架构
- 这是官方文档中的架构图
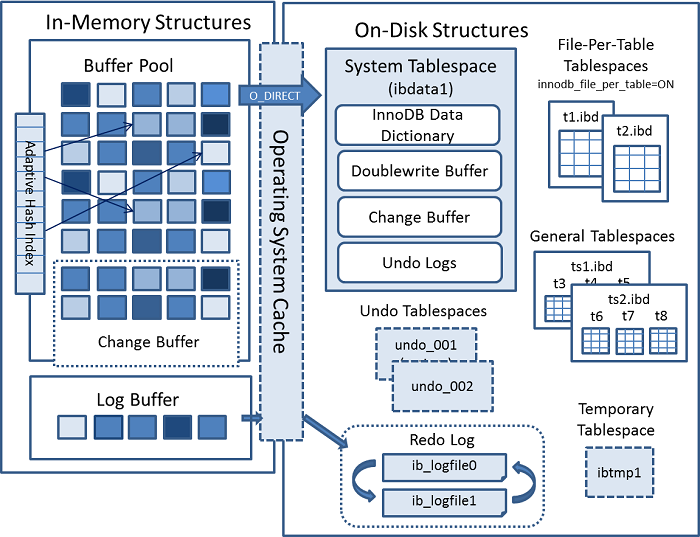
Buffer Pool
在使用 InnoDB 的时候,索引都是以页的形式存在于
表空间中的,本质上是存储在硬盘上的。设计InnoDB的大叔为了缓存磁盘中的页,在MySQL服务器启动的时候就向操作系统申请了一片连续的内存,他们给这片内存起了个名,叫做Buffer Pool(中文名是缓冲池)
[server]
innodb_buffer_pool_size = 268435456
-- 268435456的单位是字节,也就是我指定Buffer Pool的大小为256M。需要注意的是,Buffer Pool也不能太小。--
Mysql log
日志是mysql中非常重要的组成部分,记录着数据库运行期间的各种状态信息。Mysql的日志主要包括
错误日志、查询日志、慢查询日志、事物日志、二进制日志大类。
错误日志 Error Log
- 记录出错信息,也记录一些警告信息或者正确的信息。默认开启。
show vaiables like '%log_err%'
查询日志 General query log
- 记录所有对数据库请求的信息,不论这些请求是否得到了正确的执行。
show vaiables like '%general%'
慢查询日志 Show query log
- 设置一个阈值,将运行时间超过该值的所有SQL语句都记录到慢查询的日志文件中。
show variables like '%slow_query_log%'show variables like '%slow_query_time%'慢查询日志记录执行时间阀值
二进制日志 binary log
- 记录对数据库执行更改的所有操作。主要数据库的恢复、主从数据库复制同步。
show vaiables like '%log_bin%'
中继日志
- 中继日志也是二进制日志,用来给slave 库恢复
事物日志
重做日志redo和回滚日志undo
事务日志是通过redo和innodb的存储引擎日志缓冲(Innodb log buffer)来实现的,当开始一个事务的时候,会记录该事务的lsn(log sequence number)号; 当事务执行时,会往InnoDB存储引擎的日志的日志缓存里面插入事务日志;当事务提交时,必须将存储引擎的日志缓冲写入磁盘(通过innodb_flush_log_at_trx_commit来控制),也就是写数据前,需要先写日志。这种方式称为“预写日志方式”。
binlog
binlog用于记录数据库执行的写入性操作(不包括查询)的信息、以二进制的信息保保存在磁盘中,binlog是Mysql的逻辑日志,又server层进行记录。使用任何的存储引擎都会进行记录。binlog是通过追加的方式写入,当文件达到一定大小值以后,会生成全新文件来保存日志。
逻辑日志:记录sql语句的日志。
物理日志:
mysql innodb数据是保存在数据页中,物理记录的就是数据页变更。主从复制:Master端开启
binlog,然后将binlog发送到Slave端,Slave端通过重放binlog达到数据一致。数据恢复:通过
mysqlbinlog工具来恢复数据库。
日志格式
在
MySQL 5.7.7之前,默认的格式是STATEMENT,MySQL 5.7.7之后,默认值是ROW。日志格式通过binlog-format指定。
STATMENT:基于SQL语句的复制(statement-based replication, SBR),每一条会修改数据的sql语句会记录到binlog中 。- 优点:不需要记录每一行的变化,减少了 binlog 日志量,节约了 IO , 从而提高了性能;
- 缺点:在某些情况下会导致主从数据不一致,比如执行sysdate() 、 slepp() 等 。
ROW:基于行的复制(row-based replication, RBR),不记录每条sql语句的上下文信息,仅需记录哪条数据被修改了 。- 优点:不会出现某些特定情况下的存储过程、或function、或trigger的调用和触发无法被正确复制的问题 ;
- 缺点:会产生大量的日志,尤其是
alter table的时候会让日志暴涨
MIXED:基于STATMENT和ROW两种模式的混合复制(mixed-based replication, MBR),一般的复制使用STATEMENT模式保存binlog,对于STATEMENT模式无法复制的操作使用ROW模式保存binlog
statement
每一条会修改数据的sql都会记录在binlog中。
优点:不需要记录每一行的变化,减少了binlog日志量,节约了IO,提高性能。(相比row能节约多少性能 与日志量,这个取决于应用的SQL情况,正常同一条记录修改或者插入row格式所产生的日志量还小于Statement产生的日志量,但是考虑到如果带条 件的update操作,以及整表删除,alter表等操作,ROW格式会产生大量日志,因此在考虑是否使用ROW格式日志时应该跟据应用的实际情况,其所 产生的日志量会增加多少,以及带来的IO性能问题。)
缺点:由于记录的只是执行语句,为了这些语句能在slave上正确运行,因此还必须记录每条语句在执行的时候的 一些相关信息,以保证所有语句能在slave得到和在master端执行时候相同 的结果。另外mysql 的复制,像一些特定函数功能,slave可与master上要保持一致会有很多相关问题(如sleep()函数, last_insert_id(),以及user-defined functions(udf)会出现问题)。
使用以下函数的语句也无法被复制:
- LOAD_FILE()
- UUID()
- USER()
- FOUND_ROWS()
- SYSDATE() (除非启动时启用了 --sysdate-is-now 选项)
同时在INSERT …SELECT 会产生比 RBR 更多的行级锁
row
不记录sql语句上下文相关信息,仅保存哪条记录被修改。
- 优点: binlog中可以不记录执行的sql语句的上下文相关的信息,仅需要记录那一条记录被修改成什么了。所以rowlevel的日志内容会非常清楚的记录下 每一行数据修改的细节。而且不会出现某些特定情况下的存储过程,或function,以及trigger的调用和触发无法被正确复制的问题
- 缺点:所有的执行的语句当记录到日志中的时候,都将以每行记录的修改来记录,这样可能会产生大量的日志内容,比 如一条update语句,修改多条记录,则binlog中每一条修改都会有记录,这样造成binlog日志量会很大,特别是当执行alter table之类的语句的时候,由于表结构修改,每条记录都发生改变,那么该表每一条记录都会记录到日志中。
mixedlevel
- Mixed是以上两种level的混合使用,一般的语句修改使用statment格式保存binlog,如一些函数,statement无法完成主从复制的操作,则 采用row格式保存binlog,MySQL会根据执行的每一条具体的sql语句来区分对待记录的日志形式,也就是在Statement和Row之间选择 一种.新版本的MySQL中队row level模式也被做了优化,并不是所有的修改都会以row level来记录,像遇到表结构变更的时候就会以statement模式来记录。至于update或者delete等修改数据的语句,还是会记录所有行的变更。
2PC两阶段提交
mysql中在server层级别有个binlog日志,归档日志,用于备份,主从同步复制,如果采用一主多从架构,主备切换,那就必须用到binlog进行主从同步。
- 事务提交就必须保证redolog与binlog的一致性,一般情况没有开启binlog日志,事务提交不会两阶段提交,若需要主从同步就必须开启binlog使用两阶段提交保证数据一致性。
- Prepare 阶段:InnoDB 将回滚段undolog设置为 prepare 状态;将 redolog 写文件并刷盘;先写redolog,事务进入prepare状态)
- Commit 阶段:Binlog 写入文件;binlog 刷盘;InnoDB commit;
刷盘机制
Innodb下只有在事物提交的情况下才会记录binlog,此时记录还在内存中。mysql通过sync_binlog参数控制binlog刷盘时机。取值范围0-n
- 0:不去强制要求,由系统自行判断何时写入磁盘;
- 1:每次
commit的时候都要将binlog写入磁盘; - N:每N个事务,才会将
binlog写入磁盘。
redo Log
事务的四大特性里面有一个是 持久性 ,具体来说就是只要事务提交成功,那么对数据库做的修改就被永久保存下来了,不可能因为任何原因再回到原来的状态 。
保持一致性
最简单的做法是在每次事务提交的时候,将该事务涉及修改的数据页全部刷新到磁盘中。但是这么做会有严重的性能问题,
redo log包含两个部分,一个是内存中的日志缓冲redo log buffer, 另一个是磁盘上的日志文件redo logfile
Innodb是以页为单位进行磁盘交互的,而一个事务很可能只修改一个数据页里面的几个字节,这个时候将完整的数据页刷到磁盘的话,太消耗资源了。一个事务可能涉及修改多个数据页,并且这些数据页在物理上并不连续,使用随机IO写入性能太差!
- mysql 每执行一条
DML语句,先将记录写入redo log buffer,后续某个时间点再一次性将多个操作写到redo log file。这种先写日志,再写磁盘的技术就是Mysql里经常说到的WAL (write-ahead Logging)技术。 具体来说就是只记录事务对数据页做了哪些修改,这样就能完美地解决性能问题了(相对而言文件更小并且是顺序IO)。
- mysql 每执行一条
在计算机中,用户的空间
user space下的缓冲区一般情况下是不能直接写入磁盘,中间需要经过系统内核空间kerne space缓冲区Os Buffer,因此redo log buffer写入redo logfile实际上是写入Os Buffer,然后再通过系统调用fsunc()将数据刷入redo log file
刷盘机制
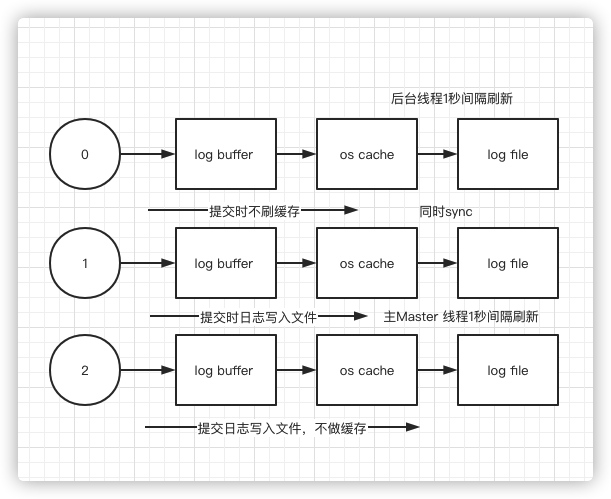
mysql 支持三种将
redo log buffer写入redo log file的机制,可以通过innodb_flush_log_at_trx_commit配置
| innodb_flush_log_at_trx_commit | 描述 |
|---|---|
| 0 | 事物提交不将redo log buffer只日志写入os buffer,而是每秒写入os buffer并调用fsync()写入redo log file中,也就是说设置0时,大概每秒刷新一次进入磁盘,如果系统出现故障,会丢失1秒的数据。 |
| 1 | 每次提交事物都将redo log buufer 写入 os buffer并调用fsync()。这种情况系统故障也不会丢失数据,io性能太差。 |
| 2 | 每次提交事物都将redo log buufer 写入 os buffer,每秒调用fsync()将os buffer中日志写入redo log file |
undo Log
数据库事务四大特性中有一个是 原子性 ,具体来说就是 原子性是指对数据库的一系列操作,要么全部成功,要么全部失败,不可能出现部分成功的情况。
- 原子性 底层就是通过
undo log实现的。undo log主要记录了数据的逻辑变化,比如一条INSERT语句,对应一条DELETE的undo log,对于每个UPDATE语句,对应一条相反的UPDATE的undo log,这样在发生错误时,就能回滚到事务之前的数据状态。 undo log也是MVCC(多版本并发控制)实现的关键。在事物提交之前Undo Log保存了未提交的版本数据,Undo log 中的数据可以作为数据旧版本提供快照读,且为其他事物提供快照读。读取顺序是Undo buffer 中查找数据,未找到就从Undo log file 中查找数据。
Redolog与Binlog
- Redo Log时属于InnoDB引擎功能,Binlog时属于Mysql Server的功能,且以二进制文件记录。
- Redo Log属于物理日志,记录数据叶更新状态内容。binLog时逻辑日志,记录更新过程。
- Redo Log日志循环写入,日志大小空间时固定的,binLog追加写入日志,不会覆盖写入。
- Redo Log在服务器异常之后可以自动恢复使用,binLog可以作为主从和数据恢复使用。binLog没有自动crash-safe能力。
MVCC
MySQL InnoDB存储引擎,实现的是基于多版本的并发控制协议——MVCC (Multi-Version Concurrency Control) 与MVCC相对的,是基于锁的并发控制,Lock-Based Concurrency Control 基于多版本的并发控制协议
- 通过 MVCC 我们可以解决以下几个问题:
- 读写之间阻塞的问题,通过 MVCC 可以让读写互相不阻塞,即读不阻塞写,写不阻塞读,这样就可以提升事务并发处理能力。
- 降低了死锁的概率。这是因为 MVCC 采用了乐观锁的方式,读取数据时并不需要加锁,对于写操作,也只锁定必要的行。
- 解决一致性读的问题。一致性读也被称为快照读,当我们查询数据库在某个时间点的快照时,只能看到这个时间点之前事务提交更新的结果,而不能看到这个时间点之后事务提交的更新结果。
隐藏字段
InnoDB存储引擎,每一行记录都有两个隐藏列trx_id、roll_pointer,如果表中没有主键和非NULL唯一键时,则还会有第三个隐藏的主键列row_id。
| 列名 | 是否必须 | 描述 |
|---|---|---|
| row_id | 否 | 单调递增的行ID,不是必需的,占用6个字节。 |
| trx_id | 是 | 记录操作该数据事务的事务ID |
| roll_pointer | 是 | 这个隐藏列就相当于一个指针,指向回滚段的undo日志 |
LBCC::Lock-Based Concurrency Control,基于锁的并发控制
MVCC::Multi-Version Concurrency Control 基于多版本的并发控制协议。纯粹基于锁的并发机制并发量低,MVCC是在基于锁的并发控制上的改进,主要是在读操作上提⾼了并发量。 MVCC最⼤的好处:读不加锁,读写不冲突。在读多写少的OLTP应⽤中,读写不冲突是⾮常重要的,极⼤的增加了系统的并发性 能,现阶段⼏乎所有的RDBMS,都⽀持了MVCC。
在MVCC并发控制中,读操作可以分成两类
- 快照读 (snapshot read):读取的是记录的可⻅版本 (有可能是历史版本),不⽤加锁(共享读锁s锁也不加,所以不会阻塞其他事务的写) 。
- 当前读 (current read):读取的是记录的最新版本,并且,当前读返回的记录,都会加上锁,保证其他事务不会再并发修改这条记录。
快照读与当前读区别
- 快照读读取的是快照数据。不加锁的简单的 SELECT 都属于快照读,比如这样:
SELECT * FROM player_users WHERE ...
当前读就是读取最新数据,而不是历史版本的数据。加锁的 SELECT,或者对数据进行增删改都会进行当前读,比如:
-- 这里加的是读锁。 update/insert/delete语句
SELECT * FROM player_users LOCK IN SHARE MODE;
SELECT * FROM player_users FOR UPDATE
Read View
每次开启事务的时候都会生成一个ReadView,ReadView保存了当前事务开启时候所有活跃(还未提交的事务)事务列表。
- 读已提交
- 一个事务中每一次SELECT查询都会获取一次ReadView
- 可重复读
- 一个事务第一次查询SELECT时会获取一次ReadView,此后的SELECT查询都会复用这个ReadView
MVCC如何查询记录
MVCC 的核心就是 Undo Log+ Read View,“MV”就是通过 Undo Log 来保存数据的历史版本,实现多版本的管理,“CC”是通过 Read View 来实现管理,通过 Read View 原则来决定数据是否显示。同时针对不同的隔离级别,Read View 的生成策略不同,也就实现了不同的隔离级别。
- 获取事务自己的版本号,即事务ID
- 获取Read View
- 查询得到的数据,然后Read View中的事务版本号进行比较。
- 如果不符合Read View的可见性规则, 即就需要Undo log中历史快照;
- 最后返回符合规则的数据
如何解决幻读
- Next key锁+MVVC避免幻读。
小结
ACID 由 undo、redo 与锁共同保证;隔离级别越高并发问题越少而开销越大,InnoDB 用 MVCC 与 Next-Key Lock 在可重复读下抑制幻读。