Redis 中不能直接使用布隆过滤器,Redis 4.0 版本之后提供的 modules(扩展模块)
布隆过滤器的原理
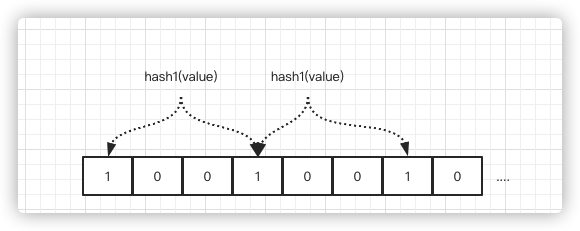
- 数据结构使用一位的数组,每次存储键值的时候,不是直接把数据存储在数据结构中。而是经过hash运算。将此元素的 hash 值均匀的存储在位数组中。把这些位置设置成 1 就完成了添加操作。
- 判断元素是否存在时,经过运算判断对应的位置是否为全部1即可。因此布隆过滤器查询此值存在时,此值不一定存在,但查询此值不存在时,此值一定不存在。
- 但是存在一定的误差,并且当位数组存储值比较稀疏的时候,查询的准确率越高,而当位数组存储的值越来越多时,误差也会增大。
- 空间占用
- 布隆过滤器有两个参数,第一个是预计元素的数量n,第二个是误判率p。公式根据这两个输入得到两个输出,第一个输出是位数组的长度m,也就是需要的存储空间大小(bit),第二个输出是hash函数的最佳数量k。hash函数的数量也会直接影响到误判率,最佳的数量会有最低的误判率。
- 计算公式
k≈0.7*(m/n)
p≈0.6185^(m/n)
- 位数组m越长,误判率p就越低;
- 位数组m越长,hash函数最佳数量k就越多,影响计算效率;
演示代码
安装Redis
演示情况直接使用docker来安装,免去下载编译过程。
docker run -p 6379:6379 -d redislabs/rebloom:latest
- 使用redis-cli或者客户端工具进入
➜  docker-run redis-cli
127.0.0.1:6379> bf.add 1 1
(integer) 0
127.0.0.1:6379> bf.add 1 2
(integer) 1
127.0.0.1:6379>
- 如果没有提示错误则表示安装成功。
Bloom基础用法
布隆过滤器的命令不是很多,主要包含以下几个
- bf.add:添加元素
- bf.exists:判断某个元素是否存在
- bf.madd:添加多个元素
- bf.mexists:判断多个元素是否存在
- bf.reserve:设置布隆过滤器的准确率 只能在未设置数据的时候设置,否则会报错
127.0.0.1:6379> bf.exists 1 1
(integer) 1
127.0.0.1:6379> bf.exists 1 2
(integer) 1
127.0.0.1:6379> bf.reserve 1 0.01 100 # 已经存在集合在设置会报错
(error) ERR item exists
127.0.0.1:6379> bf.reserve user 0.01 100 # 未设置数据的则可以正常设置。
OK
Spring Boot 演示
/**
 * @author z201.coding@gmail.com
 **/
@Component
@Slf4j
public class BloomTool {


    @Autowired
    private RedisTemplate redisTemplate;

    /**
     * 初始化
     *
     * @param key
     * @param rate 准确度
     * @param size 大小
     */
    public Boolean init(String key, String rate, String size) {
        try {
            String script = "return redis.call('bf.reserve', KEYS[1], ARGV[1], ARGV[2])";
            DefaultRedisScript<String> defaultRedisScript = new DefaultRedisScript<String>();
            defaultRedisScript.setResultType(String.class);
            defaultRedisScript.setScriptSource(new StaticScriptSource(script));
            String[] argv = new String[]{rate,size};
            String result = (String) redisTemplate.execute(defaultRedisScript, Collections.singletonList(key), argv);
            if (Objects.equals(result, "OK")) {
                return true;
            }
        }catch (RedisSystemException redisSystemException){
            log.error("{}",redisSystemException.getMessage());
        }
        return false;
    }

    /**
     * 添加元素
     *
     * @param key
     * @param value
     */
    public Boolean add(String key, String value) {
        String script = "return redis.call('bf.add', KEYS[1], ARGV[1])";
        return lua(script, key, value);
    }

    /**
     * 是否存在
     *
     * @param key
     * @param value
     * @return
     */
    public Boolean exists(String key, Object value) {
        String script = "return redis.call('bf.exists', KEYS[1], ARGV[1])";
        return lua(script, key, value);
    }

    private Boolean lua(String script, String key, Object value) {
        DefaultRedisScript<Long> defaultRedisScript = new DefaultRedisScript<Long>();
        defaultRedisScript.setResultType(Long.class);
        defaultRedisScript.setScriptSource(new StaticScriptSource(script));
        Long result = (Long) redisTemplate.execute(defaultRedisScript, Collections.singletonList(key), value);
        if (Objects.equals(result, 1L)) {
            return true;
        }
        return false;
    }

}
- 单元测试
package cn.z201.redis;

@Slf4j
@ExtendWith(SpringExtension.class)
@SpringBootTest(classes = AppApplication.class, webEnvironment = SpringBootTest.WebEnvironment.RANDOM_PORT)
@AutoConfigureMockMvc
// 指定单元测试方法顺序
@TestMethodOrder(MethodOrderer.OrderAnnotation.class)
public class AppApplicationTest {

    @Autowired
    BloomTool bloomTool;

    @Autowired
    RedisTemplate redisTemplate;

    @Test
    @Disabled
    public void testBloom() {
        Set<String> keys =  redisTemplate.keys("*");
        log.info("{}",keys);
        redisTemplate.delete(keys);
        String key = "u";
        log.info("init 异常或者错误都会报错 {}", bloomTool.init(key, "0.001", "10000000"));
        List<String> values = new ArrayList<>();
        for (int i = 0; i < 100; i++) {
            Integer value = RandomUtil.randomInt(1000, 20000000);
            values.add(value.toString());
            Boolean result =  bloomTool.add(key, value.toString());
            log.info("bf.add {} {} {} ", result, key, value);
        }
        Integer index = RandomUtil.randomInt(0, values.size());
        String value = values.get(index);
        Boolean result = bloomTool.exists(key, value);
        log.info("bf.exists {} {} {} ", result, key, value);
    }

}
- Console
[main]  [u]
[main]  init 异常或者错误都会报错 true
[main]  bf.add true u 11569209
[main]  bf.add true u 12786658
[main]  bf.add true u 16272560
[main]  bf.add true u 1212058
[main]  bf.add true u 4896410
[main]  bf.add true u 15218411
[main]  bf.add true u 13349975
[main]  bf.add true u 12544373
[main]  bf.add true u 4507958
[main]  bf.add true u 12143750
[main]  bf.exists true u 1212058
小结
位数组加多哈希使布隆过滤器不存在时必为假、存在时可能误判,bf.reserve 只能在集合为空时设误判率与容量,已有数据会返回 item exists。