Snowflake,雪花算法是由Twitter开源的分布式ID生成算法,以划分命名空间的方式将 64-bit位分割成多个部分,每个部分代表不同的含义。这种就是将64位划分为不同的段,每段代表不同的涵义,基本就是时间戳、机器ID和序列数,当然这种方案就是需要考虑时钟回拨的问题以及做一些 buffer的缓冲设计提高性能。
背景
Twitter 早期用 MySQL 存储数据,随着用户的增长,单一的 MySQL 实例没法承受海量的数据,开发团队就开始用 Cassandra 和 sharded MySQL 替代原有的系统。然而和 MySQL 不同的是,Cassandra 没有内置为每一条数据生成唯一 ID 的功能,因为在一个分布式环境下,很难有完美的 ID 生成方案。
- 对于 Twitter 而言,这样的 ID 生成方案要满足两个基本的要求,一是每秒能生成几十万条 ID 用于标识不同的 tweet;二是这些 ID 应该可以有个大致的顺序,也就是说发布时间相近的两条 tweet,它们的 ID 也应当相近,这样才能方便各种客户端对 tweet 进行排序。
- 第一个要求意味着 ID 生成要以一种非协作的(uncoordinated)的方式进行,例如不能有一个全局的原子变量。
- 第二个要求使得 tweet 按 ID 排序后满足 k-sorted 条件。如果序列 A 要满足 k-sorted,当且仅当对于任意的 p, q,如果 1 <= p <= q - k (1 <= p <= q <= n),则有 A[p] <= A[q]。换句话说,如果元素 p 排在 q 前面,且相差至少 k 个位置,那么 p 必然小于或等于 q。如果 tweet 序列满足这个条件,要获取第 r 条 tweet 之后的消息,只要从第 r - k 条开始查找即可。
- Twitter 解决这两个问题的方案非常简单高效:每一个 ID 都是 64 位数字,由时间戳、节点号和序列编号组成。其中序列编号是每个节点本地生成的序号,而节点号则由 ZooKeeper 维护。
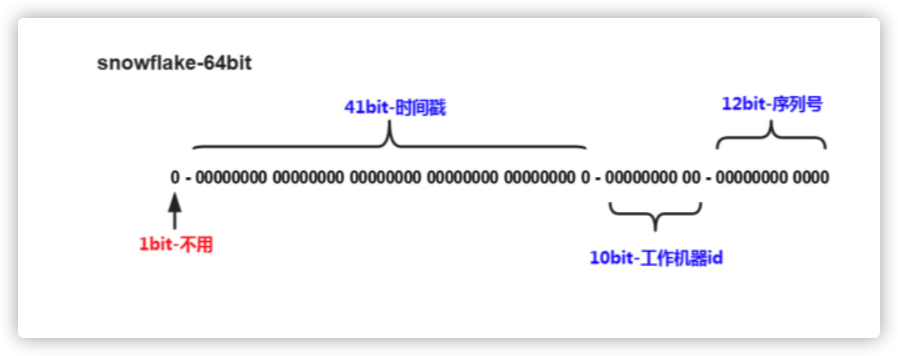
- 官网给出的代码是scala写出来的代码。
- 1bit,不用,因为二进制中最高位是符号位,1表示负数,0表示正数。生成的id一般都是用整数,所以最高位固定为0。
- 41bit-时间戳,用来记录时间戳,毫秒级。
- 41位可以表示2^41-1个数字, - 如果只用来表示正整数(计算机中正数包含0),可以表示的数值范围是:0 至 2^41-1,减1是因为可表示的数值范围是从0开始算的,而不是1。 - 也就是说41位可以表示2^41-1个毫秒的值,转化成单位年则是(2^{41}-1) / (1000 * 60 * 60 * 24 *365) = 69年
- 10bit-工作机器id,用来记录工作机器id。
- 可以部署在2^{10} = 1024个节点,包括5位datacenterId和5位workerId
- 5位(bit)可以表示的最大正整数是2^{5}-1 = 31,即可以用0、1、2、3、....31这32个数字,来表示不同的datecenterId或workerId
- 12bit-序列号,序列号,用来记录同毫秒内产生的不同id。 - 12位(bit)可以表示的最大正整数是2^{12}-1 = 4095,即可以用0、1、2、3、....4094这4095个数字,来表示同一机器同一时间截(毫秒)内产生的4095个ID序号。
Java实现
由于在Java中64bit的整数是long类型,所以在Java中SnowFlake算法生成的id就是long来存储的。
- 所有id生成按照时间趋势递增
- 理论上分布式系统不会生产重复id(因为有datacenterId和workerId来做区分)
pom依赖
<dependencies>
        <!-- JMH基准测试 -->
        <dependency>
            <groupId>org.openjdk.jmh</groupId>
            <artifactId>jmh-core</artifactId>
            <version>1.21</version>
            <scope>test</scope>
        </dependency>
        <dependency>
            <groupId>org.openjdk.jmh</groupId>
            <artifactId>jmh-generator-annprocess</artifactId>
            <version>1.21</version>
            <scope>test</scope>
        </dependency>

        <!-- 单元测试 -->
        <dependency>
            <groupId>org.junit.jupiter</groupId>
            <artifactId>junit-jupiter-api</artifactId>
            <version>5.7.1</version>
            <scope>test</scope>
        </dependency>
        <dependency>
            <groupId>org.junit.jupiter</groupId>
            <artifactId>junit-jupiter-engine</artifactId>
            <version>5.7.1</version>
            <scope>test</scope>
        </dependency>
    </dependencies>
Java代码
package cn.z201.example;

import java.time.Clock;

/**
 * @author z201.coding@gmail.com
 **/
public class SnowflakeDistributeId {

    /**
     * 开始时间截,这里用系统的时间戳
     */
    private final long startTime = 1420041600000L;

    /**
     * 机器id所占的位数 5 位
     */
    private final static long WORKER_ID_BITS = 5L;
    /**
     * 序列在id中占的位数
     */
    private final static long SEQUENCE_BITS = 12L;
    /**
     * 数据标识id所占的位数
     */
    private final long DATA_CENTER_ID_BITS = 5L;

    /**
     * 数据中心最大数量。支持的最大机器id,结果是31 (这个移位算法可以很快计算出几位二进制数所能表示的最大十进制数)
     */
    private final long maxWorkerId = -1L ^ (-1L << WORKER_ID_BITS); //

    /**
     * 支持的最大数据标识id,结果是31
     */
    private final long maxDatacenterId = -1L ^ (-1L << DATA_CENTER_ID_BITS);

    /**
     * 机器ID向左移12位
     */
    private final long workerIdShift = SEQUENCE_BITS;

    /**
     * 数据标识id向左移17位(12+5)
     */
    private final long datacenterIdShift = SEQUENCE_BITS + WORKER_ID_BITS;

    /**
     * 时间截向左移22位(5+5+12)
     */
    private final long timestampLeftShift = SEQUENCE_BITS + WORKER_ID_BITS + DATA_CENTER_ID_BITS;

    /**
     * 生成序列的掩码,这里为4095 (0b111111111111=0xfff=4095)
     */
    private final long sequenceMask = -1L ^ (-1L << SEQUENCE_BITS);

    /**
     * 工作机器ID(0~31)
     */
    private long workerId;

    /**
     * 数据中心ID(0~31)
     */
    private long datacenterId;

    /**
     * 毫秒内序列(0~4095)
     */
    private long sequence = 0L;

    /**
     * 上次生成ID的时间截
     */
    private long lastTimestamp = -1L;

    /**
     * 禁止参的构造,规避创建对象时候使用默认的机器码
     */
    private SnowflakeDistributeId() {
    }

    /**
     * 构造函数
     *
     * @param workerId     工作ID (0~31)
     * @param datacenterId 数据中心ID (0~31)
     */
    public SnowflakeDistributeId(long workerId, long datacenterId) {
        if (workerId > maxWorkerId || workerId < 0) {
            throw new IllegalArgumentException(String.format("worker Id can't be greater than %d or less than 0", maxWorkerId));
        }
        if (datacenterId > maxDatacenterId || datacenterId < 0) {
            throw new IllegalArgumentException(String.format("datacenter Id can't be greater than %d or less than 0", maxDatacenterId));
        }
        this.workerId = workerId;
        this.datacenterId = datacenterId;
    }

    /**
     * 获得下一个ID (该方法是线程安全的)
     *
     * @return SnowflakeId
     */
    public synchronized long nextId() {
        long timestamp = Clock.systemDefaultZone().millis();
        //如果当前时间小于上一次ID生成的时间戳,说明系统时钟回退过这个时候应当抛出异常
        if (timestamp < lastTimestamp) {
            throw new RuntimeException(
                    String.format("Clock moved backwards.  Refusing to generate id for %d milliseconds", lastTimestamp - timestamp));
        }
        //如果是同一时间生成的,则进行毫秒内序列
        if (lastTimestamp == timestamp) {
            sequence = (sequence + 1) & sequenceMask;
            //毫秒内序列溢出,序列数已经达到最大
            if (sequence == 0) {
                //阻塞到下一个毫秒,获得新的时间戳
                timestamp = tilNextMillis(lastTimestamp);
            }
        } else {
            //时间戳改变,毫秒内序列重置
            sequence = 0L;
        }
        //上次生成ID的时间截
        lastTimestamp = timestamp;

        //移位并通过或运算拼到一起组成64位的ID
        return ((timestamp - startTime) << timestampLeftShift) // 时间戳部分
                | (datacenterId << datacenterIdShift) // 数据中心部分
                | (workerId << workerIdShift) // 机器标识符部分
                | sequence; // 序列号部分
    }

    /**
     * 阻塞到下一个毫秒,直到获得新的时间戳
     *
     * @param lastTimestamp 上次生成ID的时间截
     * @return 当前时间戳
     */
    protected long tilNextMillis(long lastTimestamp) {
        long timestamp = Clock.systemDefaultZone().millis();
        while (timestamp <= lastTimestamp) {
            timestamp = Clock.systemDefaultZone().millis();
        }
        return timestamp;
    }


}
JMH基准测试
package cn.z201.example;

import org.openjdk.jmh.annotations.*;
import org.openjdk.jmh.results.format.ResultFormatType;
import org.openjdk.jmh.runner.Runner;
import org.openjdk.jmh.runner.RunnerException;
import org.openjdk.jmh.runner.options.Options;
import org.openjdk.jmh.runner.options.OptionsBuilder;

import java.util.concurrent.TimeUnit;

public class SnowflakeDistributeIdTest {

    private final static Integer MEASUREMENT_ITERATIONS = 1;
    private final static Integer WARMUP_ITERATIONS = 10;

    public static void main(String[] args) throws RunnerException {
        Options opt = new OptionsBuilder()
                // 设置类名正则表达式基准为搜索当前类
                .include("\\." + SnowflakeDistributeIdTest.class.getSimpleName() + "\\.")
                // 都是一些基本的参数,可以根据具体情况调整。一般比较重的东西可以进行大量的测试,放到服务器上运行。
                .warmupIterations(WARMUP_ITERATIONS) // 多少次预热
                .measurementIterations(MEASUREMENT_ITERATIONS) // 要做多少次测量m
                .timeUnit(TimeUnit.MILLISECONDS) // 毫秒
                // 不使用多线程
                .forks(1) // 进行 fork 的次数。如果 fork 数是2的话,则 JMH 会 fork 出两个进程来进行测试。
                .threads(1) // 每个进程中的测试线程,这个非常好理解,根据具体情况选择,一般为cpu乘以2。
                // Throughput 整体吞吐量,例如”1秒内可以执行多少次调用”。
                // AverageTime: 调用的平均时间,例如”每次调用平均耗时xxx毫秒”。
                // SampleTime: 随机取样,最后输出取样结果的分布,例如”99%的调用在xxx毫秒以内,99.99%的调用在xxx毫秒以内”
                // SingleShotTime: 以上模式都是默认一次 iteration 是 1s,唯有 SingleShotTime 是只运行一次。往往同时把 warmup 次数设为0,用于测试冷启动时的性能。
                // All(“all”, “All benchmark modes”);
                .mode(Mode.AverageTime)
                .shouldDoGC(true)
                .shouldFailOnError(true)             //
                .resultFormat(ResultFormatType.JSON) // 输出格式化
//                .result("/dev/null") // set this to a valid filename if you want reports
                .result("benchmark.log")
                .shouldFailOnError(true)
                .jvmArgs("-server")
                .build();
        new Runner(opt).run();
    }

    /**
     * Benchmark 方法级注解,表示该方法是需要进行 benchmark 的对象,用法和 JUnit 的 @Test 类似。
     */
    @Benchmark
    public void testSnowflakeDistributeId() {
        SnowflakeDistributeId idWorker = new SnowflakeDistributeId(0, 0);
        for (int i = 0; i < 1000000; i++) {
            long id = idWorker.nextId();
        }
    }
}
- Console
[
    {
        "jmhVersion" : "1.21",
        "benchmark" : "cn.z201.example.SnowflakeDistributeIdTest.testSnowflakeDistributeId",
        "mode" : "avgt",
        "threads" : 1,
        "forks" : 1,
        "jvm" : "/Library/Java/JavaVirtualMachines/adoptopenjdk-8.jdk/Contents/Home/jre/bin/java",
        "jvmArgs" : [
            "-server"
        ],
        "jdkVersion" : "1.8.0_275",
        "vmName" : "OpenJDK 64-Bit Server VM",
        "vmVersion" : "25.275-b01",
        "warmupIterations" : 10,
        "warmupTime" : "10 s",
        "warmupBatchSize" : 1,
        "measurementIterations" : 1,
        "measurementTime" : "10 s",
        "measurementBatchSize" : 1,
        "primaryMetric" : {
            "score" : 244.1343217804878,
            "scoreError" : "NaN",
            "scoreConfidence" : [
                "NaN",
                "NaN"
            ],
            "scorePercentiles" : {
                "0.0" : 244.1343217804878,
                "50.0" : 244.1343217804878,
                "90.0" : 244.1343217804878,
                "95.0" : 244.1343217804878,
                "99.0" : 244.1343217804878,
                "99.9" : 244.1343217804878,
                "99.99" : 244.1343217804878,
                "99.999" : 244.1343217804878,
                "99.9999" : 244.1343217804878,
                "100.0" : 244.1343217804878
            },
            "scoreUnit" : "ms/op",
            "rawData" : [
                [
                    244.1343217804878
                ]
            ]
        },
        "secondaryMetrics" : {
        }
    }
]
- 生成比较平稳。还没测试在多线程情况下的效果。
小结
64 位 ID 由 41 位毫秒时间戳、10 位机器标识与 12 位序列组成,单机每毫秒上限 4095 个,时间戳可用约 69 年。实现遇时钟回拨直接抛异常,百万次单线程约 244ms。