HashMap 用平均 O(1) 的读写支撑了大多数键值场景,但它的性能并非没有代价:容量必须是 2 的幂,默认负载因子是 0.75,链表长度达到 8 才树化。这些常量彼此约束。本文沿着一次 put 的路径,解释它们如何共同工作,以及哪些用法会让 HashMap 退化。
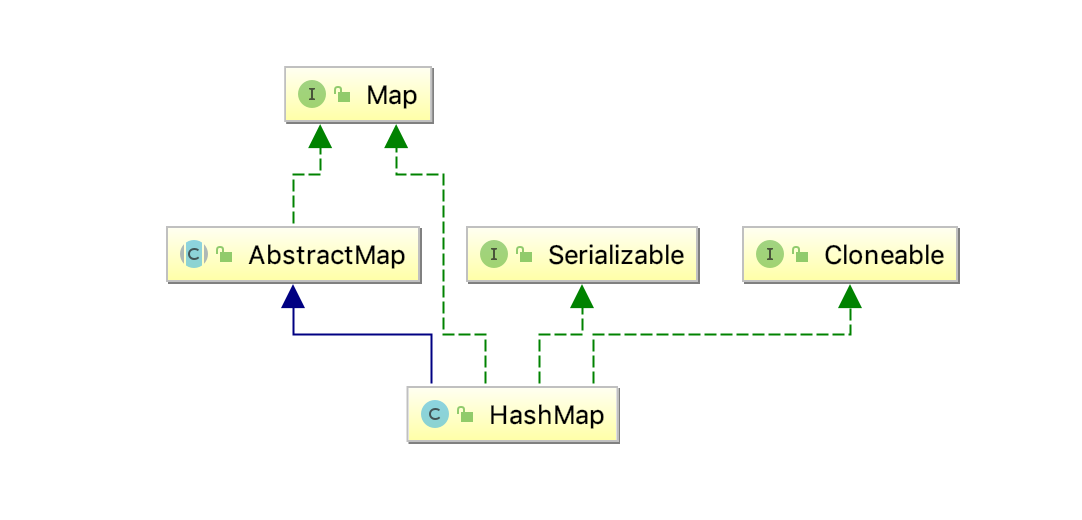
结构:数组、链表与红黑树
HashMap 的主体是一个 Node<K, V>[] table 数组,每个数组位置称为一个桶(bucket)。桶内先以单链表保存冲突元素;当冲突足够多时,链表会转换为红黑树。
| 常量 | 默认值 | 作用 |
|---|---|---|
DEFAULT_INITIAL_CAPACITY | 16(2⁴) | 未指定容量时的初始桶数 |
MAXIMUM_CAPACITY | 2³⁰ | 允许的最大容量 |
DEFAULT_LOAD_FACTOR | 0.75 | 扩容阈值 = 容量 × 负载因子 |
TREEIFY_THRESHOLD | 8 | 桶内链表达到该长度时尝试树化 |
UNTREEIFY_THRESHOLD | 6 | 树节点减少到该数量时退回链表 |
MIN_TREEIFY_CAPACITY | 64 | 容量低于该值时优先扩容,而不是树化 |
默认配置下,第一次 put 会把表初始化为 16 个桶,扩容阈值是 12。也就是说,第 13 个键值对写入时触发扩容。
几个使用层面的结论:
- 允许一个
null键和任意数量的null值,null键的哈希值按 0 处理,固定落在 0 号桶。 - 不保证顺序。迭代顺序既不是插入顺序,也不保证多次运行一致;需要顺序时使用
LinkedHashMap。 - 不是线程安全的。多线程写场景应使用
ConcurrentHashMap,而不是依赖Collections.synchronizedMap()的全表锁。
哈希定位:key 进入哪个桶
JDK 8 没有直接使用 hashCode(),而是先做一次扰动:
static final int hash(Object key) {
    int h;
    return (key == null) ? 0 : (h = key.hashCode()) ^ (h >>> 16);
}
高 16 位与低 16 位异或,让高位信息参与后续的取模运算。数组下标通过位运算得到:
int index = (n - 1) & hash; // n 是容量
容量为 2 的幂时,(n - 1) & hash 等价于 hash % n,但位运算更快;这也解释了为什么 HashMap 始终把容量向上取整到 2 的幂。
键的相等性由 hashCode() 与 equals() 共同决定:
- 两个键
equals为true,hashCode必须相同;否则会出现“明明相等却存了两份”的错误。 - 作为键的对象在放入后不应改变参与
hashCode()计算的字段,否则哈希值变化,get将找不到原节点。 - 自定义键需要同时正确重写
hashCode()和equals(),只重写其中一个都会导致冲突处理异常。
一次 put 的完整流程
put 的实际工作由 putVal 完成,可以拆成六步:
- 表未初始化或长度为 0 时,先调用
resize()创建底层数组。 - 用
(n - 1) & hash定位桶;桶为空则直接新建节点放入。 - 桶首节点的 hash 与 key 都相同,记录该节点,走替换流程。
- 首节点是树节点,调用
putTreeVal在红黑树中查找或插入。 - 否则遍历链表:找到相同 key 就记录并替换;到达链尾则追加新节点。追加后链表长度达到 8 时调用
treeifyBin。 - 如果是新增键值对,
size加一;超过阈值则扩容。
核心源码如下,注释做了整理:
final V putVal(int hash, K key, V value, boolean onlyIfAbsent,
               boolean evict) {
    Node<K,V>[] tab; Node<K,V> p; int n, i;
    // 1. 首次写入或空表:初始化
    if ((tab = table) == null || (n = tab.length) == 0)
        n = (tab = resize()).length;
    // 2. 定位桶,空桶直接放入
    if ((p = tab[i = (n - 1) & hash]) == null)
        tab[i] = newNode(hash, key, value, null);
    else {
        Node<K,V> e; K k;
        // 3. 与首节点 key 相同
        if (p.hash == hash &&
            ((k = p.key) == key || (key != null && key.equals(k))))
            e = p;
        // 4. 树节点
        else if (p instanceof TreeNode)
            e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value);
        else {
            // 5. 遍历链表:命中则替换,否则追加
            for (int binCount = 0; ; ++binCount) {
                if ((e = p.next) == null) {
                    p.next = newNode(hash, key, value, null);
                    if (binCount >= TREEIFY_THRESHOLD - 1)
                        treeifyBin(tab, hash);
                    break;
                }
                if (e.hash == hash &&
                    ((k = e.key) == key || (key != null && key.equals(k))))
                    break;
                p = e;
            }
        }
        // 命中已有 key:按 onlyIfAbsent 决定是否覆盖
        if (e != null) {
            V oldValue = e.value;
            if (!onlyIfAbsent || oldValue == null)
                e.value = value;
            afterNodeAccess(e);
            return oldValue;
        }
    }
    ++modCount;
    // 6. 超过阈值扩容
    if (++size > threshold)
        resize();
    afterNodeInsertion(evict);
    return null;
}
查找路径与之对应:先比较桶首节点,再进入红黑树或遍历链表。平均情况下桶内元素很少,复杂度接近 O(1);最坏情况在树化前是 O(n),树化后降为 O(log n)。
扩容:为什么每次翻倍
默认阈值是 12,写入第 13 个元素时触发 resize()。扩容后的容量是原来的两倍,阈值也随容量同比放大。由于容量始终是 2 的幂,扩容时不需要重新计算每个 key 的完整哈希,只需判断一个额外的高位:
// 原桶中的节点只可能留在 j,或迁移到 j + oldCap
if ((e.hash & oldCap) == 0) {
    // 留在低位链
} else {
    // 迁移到高位链
}
JDK 8 在拆分链表时保留了节点原有的相对顺序,避免旧版本扩容后链表倒置的问题。
final Node<K,V>[] resize() {
    Node<K,V>[] oldTab = table;
    int oldCap = (oldTab == null) ? 0 : oldTab.length;
    int oldThr = threshold;
    int newCap, newThr = 0;

    if (oldCap > 0) {
        if (oldCap >= MAXIMUM_CAPACITY) {
            threshold = Integer.MAX_VALUE;
            return oldTab;
        }
        if ((newCap = oldCap << 1) < MAXIMUM_CAPACITY &&
            oldCap >= DEFAULT_INITIAL_CAPACITY)
            newThr = oldThr << 1;
    } else if (oldThr > 0) {
        // 构造时只设置了阈值,首次扩容用它作为容量
        newCap = oldThr;
    } else {
        newCap = DEFAULT_INITIAL_CAPACITY;
        newThr = (int)(DEFAULT_LOAD_FACTOR * DEFAULT_INITIAL_CAPACITY);
    }

    if (newThr == 0) {
        float ft = (float)newCap * loadFactor;
        newThr = (newCap < MAXIMUM_CAPACITY && ft < (float)MAXIMUM_CAPACITY
                  ? (int)ft : Integer.MAX_VALUE);
    }

    threshold = newThr;
    Node<K,V>[] newTab = (Node<K,V>[])new Node[newCap];
    table = newTab;

    if (oldTab != null) {
        for (int j = 0; j < oldCap; ++j) {
            Node<K,V> e;
            if ((e = oldTab[j]) != null) {
                oldTab[j] = null;
                if (e.next == null)
                    newTab[e.hash & (newCap - 1)] = e;
                else if (e instanceof TreeNode)
                    ((TreeNode<K,V>)e).split(this, newTab, j, oldCap);
                else {
                    Node<K,V> loHead = null, loTail = null;
                    Node<K,V> hiHead = null, hiTail = null;
                    Node<K,V> next;
                    do {
                        next = e.next;
                        if ((e.hash & oldCap) == 0) {
                            if (loTail == null) loHead = e;
                            else loTail.next = e;
                            loTail = e;
                        } else {
                            if (hiTail == null) hiHead = e;
                            else hiTail.next = e;
                            hiTail = e;
                        }
                    } while ((e = next) != null);
                    if (loTail != null) {
                        loTail.next = null;
                        newTab[j] = loHead;
                    }
                    if (hiTail != null) {
                        hiTail.next = null;
                        newTab[j + oldCap] = hiHead;
                    }
                }
            }
        }
    }
    return newTab;
}
扩容是 O(n) 的全量迁移。频繁扩容比查询本身更伤性能,已知数据规模时应当预分配容量:
// 期望存放 expectedSize 个元素,按默认负载因子反推容量
int capacity = (int)(expectedSize / 0.75f) + 1;
Map<String, Object> map = new HashMap<>(capacity);
构造器传入的容量会被 tableSizeFor 向上取整到最近的 2 的幂。传入 10 实际得到 16,传入 17 得到 32。
树化与退化
链表转红黑树需要同时满足两个条件:
- 单个桶内的链表长度达到 8;
- 当前表容量不小于 64。
容量不足 64 时,treeifyBin 会先扩容。原因是小表下桶冲突可能只是容量太小,扩容即可分散节点,过早树化反而增加节点体积和维护成本。
树退化为链表的常见时机:
- 扩容拆分后,某个树桶的节点数降到 6 及以下;
- 删除节点后树过小,
removeTreeNode触发退化。
负载因子 0.75 下,桶内节点数近似服从泊松分布,长度达到 8 的概率极低,因此 8 是一个兼顾查询性能与内存占用的阈值。本文不展开红黑树的旋转与染色,只讨论它与 HashMap 的交互边界。
常见误区与使用建议
误区一:HashMap 有序。 它不保证顺序,扩容后顺序还可能变化。需要插入顺序用 LinkedHashMap,需要排序用 TreeMap。
误区二:null 键没有风险。 允许 null 键不等于应该使用。业务键使用 null 会掩盖上游数据缺失,也让类型约束失效。
误区三:Collections.synchronizedMap() 等于高并发安全。 它给每个方法加同一把锁,吞吐有限;并发读写应优先 ConcurrentHashMap。
误区四:容量随便写。 频繁写入的场景应按预估规模预分配,减少扩容次数;但也不要盲目设置过大容量,空桶同样占用内存。
误区五:可变对象可以做键。 键对象的字段变化会改变哈希值,导致已存入的映射无法通过 get 找回。键应尽量使用不可变类型。
小结
- HashMap 是“数组 + 链表 + 红黑树”的组合结构,容量始终为 2 的幂。
- 哈希定位依赖
(n - 1) & hash,高 16 位扰动用于改善低位分布。 put依次处理初始化、定位、替换、树化与扩容,平均复杂度 O(1)。- 扩容按 2 倍进行,桶内节点要么留在原位,要么迁移到
j + oldCap。 - 线程安全、顺序和可变键是比“时间复杂度”更容易踩的三个坑。