本章是整理知识内容,为强化知识长期更新。
Vector
概述
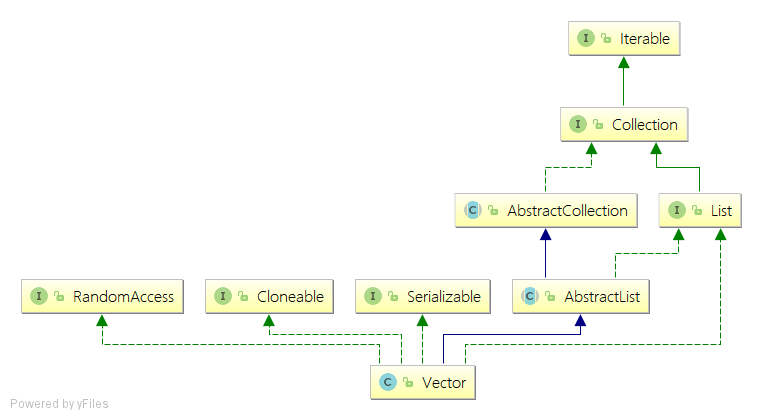
- Vector 是 Java Collection Framework 成员。
- 允许添加重复元素。
- 允许存放 null。
- 下标从 0 开始,集合头部的下标是 0。
- 支持泛型,可以避免
ClassCastException异常。
与 ArrayList 的区别
Vector 与 ArrayList 的实现几乎完全相同,不同之处主要有三点:
- Vector 是同步的,多数方法带
synchronized修饰,开销比 ArrayList 大很多。 - 默认扩容倍数不同:ArrayList 是 1.5 倍,Vector 是 2 倍,也可以通过扩容系数指定增量。
- 相对于 ArrayList,Vector 用性能换取了同步;但需要线程安全的 List 时,更推荐
Collections.synchronizedList(new ArrayList<>()),或使用concurrent包下的CopyOnWriteArrayList。
因此一般不建议直接使用 Vector。
源码:字段与构造方法
Vector 内部的常量与变量:
// 集合中的数组元素
protected Object[] elementData;

// 集合中数组大小,这里不是用 size。
protected int elementCount;

// 扩容的时候增长数量,如果是 0 或者负数就按 2 倍扩容。
protected int capacityIncrement;

// 容器的最大容量
private static final int MAX_ARRAY_SIZE = Integer.MAX_VALUE - 8;
四个构造方法分别对应指定初始容量与扩容系数、只指定初始容量、默认构造和从集合复制:
@Test
public void test() {
    String[] arr = new String[]{"a", "b", "c", "d"};
    Vector list = new Vector(1, 10);
    list.addAll(Arrays.asList(arr));
    System.out.println(list);

    Vector list1 = new Vector(10);
    list1.addAll(Arrays.asList(arr));
    System.out.println(list1);

    Vector list2 = new Vector();
    list2.addAll(Arrays.asList(arr));
    System.out.println(list2);

    Vector list3 = new Vector(Arrays.asList(arr));
    System.out.println(list3);
}
输出:
[a, b, c, d]
[a, b, c, d]
[a, b, c, d]
[a, b, c, d]
// list 指定初始容量与扩容系数
public Vector(int initialCapacity, int capacityIncrement) {
    super();
    if (initialCapacity < 0)
        throw new IllegalArgumentException("Illegal Capacity: " +
                                           initialCapacity);
    this.elementData = new Object[initialCapacity];
    this.capacityIncrement = capacityIncrement;
}

// list1 只指定初始容量,扩容系数为 0
public Vector(int initialCapacity) {
    this(initialCapacity, 0);
}

// list2 默认构造,初始容量为 10
public Vector() {
    this(10);
}

// list3 复制另一个集合的元素
public Vector(Collection<? extends E> c) {
    elementData = c.toArray();
    elementCount = elementData.length;
    // c.toArray might (incorrectly) not return Object[] (see 6260652)
    if (elementData.getClass() != Object[].class)
        elementData = Arrays.copyOf(elementData, elementCount, Object[].class);
}
扩容逻辑
Vector 的添加方法与 ArrayList 相似,区别在扩容计算:
// 从 add 方法入口看
public synchronized boolean add(E e) {
    modCount++;
    ensureCapacityHelper(elementCount + 1);  // 判断扩容
    elementData[elementCount++] = e;
    return true;
}

private void ensureCapacityHelper(int minCapacity) {
    // overflow-conscious code
    // 如果最小容量不够用了就扩容
    if (minCapacity - elementData.length > 0)
        grow(minCapacity);
}

private void grow(int minCapacity) {
    // overflow-conscious code
    // 容器原始大小
    int oldCapacity = elementData.length;
    // capacityIncrement > 0 时按增量扩容,否则容量翻倍
    int newCapacity = oldCapacity + ((capacityIncrement > 0) ?
                                     capacityIncrement : oldCapacity);
    if (newCapacity - minCapacity < 0)
        newCapacity = minCapacity;
    // 判断新大小是否超过最大限制
    if (newCapacity - MAX_ARRAY_SIZE > 0)
        newCapacity = hugeCapacity(minCapacity);
    // 复制生成新的数组
    elementData = Arrays.copyOf(elementData, newCapacity);
}

private static int hugeCapacity(int minCapacity) {
    if (minCapacity < 0) // overflow
        throw new OutOfMemoryError();
    return (minCapacity > MAX_ARRAY_SIZE) ?
        Integer.MAX_VALUE :
        MAX_ARRAY_SIZE;
}
Stack
概述
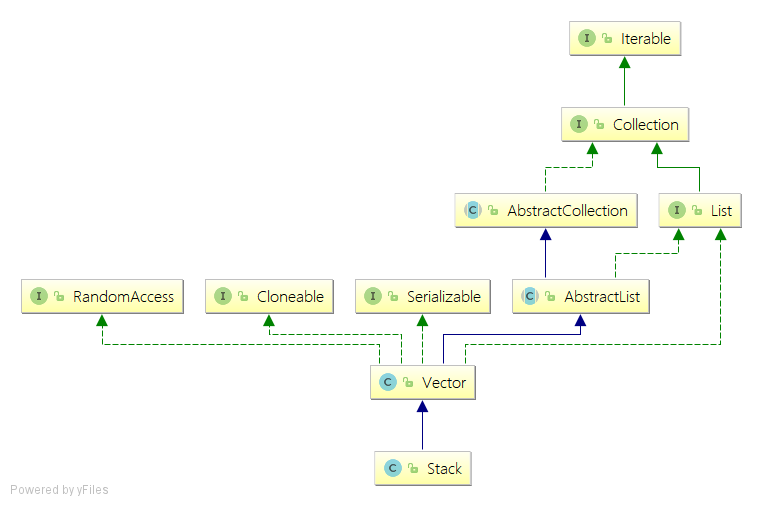
Stack 是 Collection 的成员之一,继承 Vector,通过重写 Vector 实现 LIFO(Last-in-First-out,后进先出):
- 栈是元素的集合,包含两个基本操作:push 把元素压入栈顶,pop 把栈顶元素移除。
- 遵循后进先出原则。
- 时间复杂度:索引
O(n)、搜索O(n)、插入O(1)、移除O(1)。 - Stack 只有一个构造方法,维持集合特性的能力全部继承自 Vector。
源码分析
方法不多,直接看整个类:
public
class Stack<E> extends Vector<E> {
    /**
     * Creates an empty Stack.
     */
    public Stack() {
    }

    // 将对象推到堆叠顶部。
    public E push(E item) {
        addElement(item);

        return item;
    }

    // 删除堆栈顶部的对象,并返回该对象作为此函数的值。
    public synchronized E pop() {
        E       obj;
        int     len = size();

        obj = peek();
        removeElementAt(len - 1);

        return obj;
    }

    // 查看堆栈顶部的对象,而不将其从堆栈中移除。
    public synchronized E peek() {
        int     len = size();

        if (len == 0)
            throw new EmptyStackException();
        return elementAt(len - 1);
    }

    // 判断 Stack 是否为空,也就是长度为 0 的时候。
    public boolean empty() {
        return size() == 0;
    }

    // 返回一个对象在堆栈上的基于 1 的位置,找不到就返回 -1。
    public synchronized int search(Object o) {
        int i = lastIndexOf(o);

        if (i >= 0) {
            return size() - i;
        }
        return -1;
    }

    /** use serialVersionUID from JDK 1.0.2 for interoperability */
    private static final long serialVersionUID = 1224463164541339165L;
}
常用操作
push 把元素追加到集合尾部,也就是栈顶:
@Test
public void test() {
    String[] arr = new String[]{"a", "b", "c", "d"};
    Stack stack = new Stack();
    stack.addAll(Arrays.asList(arr));
    System.out.println(stack);
    stack.push("a");
    System.out.println(stack);
}
// 输出
[a, b, c, d]
[a, b, c, d, a]
pop 移除并返回栈顶元素:
@Test
public void test1() {
    String[] arr = new String[]{"a", "b", "c", "d"};
    Stack stack = new Stack();
    stack.addAll(Arrays.asList(arr));
    System.out.println(stack);
    stack.pop();
    System.out.println(stack);
}
// 输出
[a, b, c, d]
[a, b, c]
peek 只读取栈顶元素,不改变栈:
@Test
public void test2() {
    String[] arr = new String[]{"a", "b", "c", "d"};
    Stack<String> stack = new Stack();
    stack.addAll(Arrays.asList(arr));
    System.out.println(stack);
    String str = stack.peek();
    System.out.println(str);
    System.out.println(stack);
}
// 输出
[a, b, c, d]
d
[a, b, c, d]
search 返回元素距离栈顶的位置,从 1 开始计数:
@Test
public void test3() {
    String[] arr = new String[]{"a", "b", "c", "d"};
    Stack<String> stack = new Stack();
    stack.addAll(Arrays.asList(arr));
    System.out.println(stack);
    Integer index = stack.search("a");
    System.out.println(index);
    index = stack.search("b");
    System.out.println(index);
}
// 输出
[a, b, c, d]
4
3
小结
Vector 方法多为 synchronized,扩容按 capacityIncrement 递增、未指定时翻倍,开销大于 ArrayList 的 1.5 倍;Stack 继承 Vector,push 调用 addElement,pop 先 peek 再 removeElementAt,空栈 peek 抛 EmptyStackException。两者都建议用 Deque 或并发容器替代。